データ消費操作ガイド
ダウンロード
フォーカスモード
フォントサイズ
操作シナリオ
データをKafkaに同期した後、0.11バージョン以上のKafkaクライアントを使用してサブスクリプションデータを消費できます。このドキュメントでは、Java、Go、Python言語のクライアント消費Demoサンプルを提供しており、データ消費のプロセスを迅速にテストし、データ形式の解析方法を理解するのに役立ちます。
注意事項
1. Demoにはデータ消費の使用方法のデモは含まれておらず、データの印刷処理のみが行われています。お客様はこれに基づいてデータ処理ロジックを自身で作成する必要があります。他の言語のKafkaクライアントを使用してデータを消費し、解析することもできます。
2. Kafkaに書き込まれるデータは、オープンソースツールCanalの形式と互換性があり、ProtobufまたはJSONのシリアル化プロトコルを採用しています。同期タスクを設定する過程で、データ形式としてCanal ProtoBufまたはCanal JSONを選択できます。
3. ターゲットCkafkaで設定するメッセージサイズの上限は、ソースデータベースのテーブル内の単一行データの最大値より大きくする必要があります。これにより、データを正常にターゲット側へ同期できます。
4. データの再入可能性を保証するために、DTSはCHECKPOINTメカニズムを導入しています。トランザクション間にCHECKPOINTメッセージを挿入してデータ同期の位置を識別し、タスクが中断後に再起動されると、中断した場所から再開できます。また、コンシューマー側はCHECKPOINTメッセージを受信すると、Kafkaの消費位置のコミットを一度実行し、消費位置をタイムリーに更新します。
ユーザーがCHECKPOINTを気にする場合、消費するメッセージにCHECKPOINTメッセージが含まれることを望まない場合は、タスクの設定中にCHECKPOINTメッセージのフィルタリングを設定できます。フィルタリング後も、DTSはタスク再起動後の再開を実現できますが、ターゲット側Kafkaに書き込む際にCHECKPOINTメッセージは挿入されません。
5. ソースデータベース内のTimestampタイプのフィールドは、ターゲット側に同期されると0タイムゾーンに変換されます(例:「2021-05-17 07:22:42 +00:00」)。データを消費する際は、お客様のシナリオに応じて、このフィールドに対してフォーマット変換を行うかどうかを評価してください。
6. JSONデータ形式を選択した場合、ソース側MySQLの数値型について、DTSがKafkaに書き込む際に文字列型に変換されます。そのうちFLOAT型とDOUBLE型は、文字列に変換される際に絶対値が1e-4未満または1e+6以上の場合、結果は科学技術計算の指数表記で表示されます。科学技術計算の指数表記は、仮数に10の累乗を掛けた形式で浮動小数点数を表します。これにより、その桁数と正確な値をより明確に示すことができ、同時にストレージ容量を節約できます。コンシューマー側でユーザーが数値型に変換する必要がある場合は、科学技術計算の指数表記で表された浮動小数点数の文字列に対して特別な処理を行うように注意してください。
Demoのダウンロードを消費
同期タスクの設定では、異なるデータ形式を選択できます。具体的には以下の通りです。タスク設定時に選択した形式に応じて、こちらのDemoをダウンロードする際も、対応する形式のDemoをダウンロードする必要があります。
Avro:バイナリ形式で、消費効率がより高くなります。
JSON:軽量なテキスト形式で、より簡単に使用できます。
Canal ProtBuf:Canalに対応したProtoBufデータ形式です。
Canal JSON:Canalに対応したJSONデータ形式です。
以下に提供するDemo例には、対応するAvro/JSON/ProtoBufプロトコルファイルがすべて含まれているため、別途ダウンロードする必要はありません。Demo内のロジック解説および主要パラメータの説明については、Demo 説明を参照してください。
Java Demoの使用説明
コンパイル環境:MavenまたはGradleパッケージ管理ツール、JDK8。ユーザーはパッケージツールを自身で選択できます。以下ではMavenを例として説明します。
操作手順:
1. Java Demoをダウンロードして、そのファイルを解凍してください。
2. 解凍後のディレクトリに入ります。利用しやすいように、ディレクトリにはMavenモデルファイルとpom.xmlファイルがそれぞれ配置されています。ユーザーは必要に応じて選択してください。
Mavenを使用してパッケージングします:mvn clean package。
3. Demoを実行します。
Mavenでパッケージングした後、ターゲットフォルダtargetに入ります。
データ形式としてAvro形式を選択し、以下のコードを実行します:
java -jar consumerDemo.jar --brokers xxx --topic xxx --group xxx --trans2sqlデータ形式としてJSON形式を選択し、以下のコードを実行します:
java -jar consumerDemo.jar --brokers xxx --topic xxx --group xxx --trans2sqlデータ形式としてCanal ProtoBuf形式を選択し、以下のコードを実行します:
java -jar consumerDemo.jar --brokers xxx --topic xxx --group xxxデータ形式としてCanal JSON形式を選択し、以下のコードを実行します:
java -jar consumerDemo.jar --brokers xxx --topic xxx --group xxx --flatMessage各パラメータの詳細説明は以下の通りです:
パラメータ | 説明 |
brokers | CKafkaのアクセスアドレスです。 |
topic | 同期タスクで設定されたtopic名です。 |
group | 消費グループ名です。ユーザーは事前にCkafkaで消費グループを作成できます。ここでカスタム入力することもできます。 |
trans2sql | SQL文に変換するかどうかを示します。このパラメータを指定するとSQL文に変換され、指定しない場合は変換されません。 Avro、JSON形式を選択する場合に設定が必要です。 |
flatMessage | Canal JSONデータ形式のみを選択する場合に必要です。 |
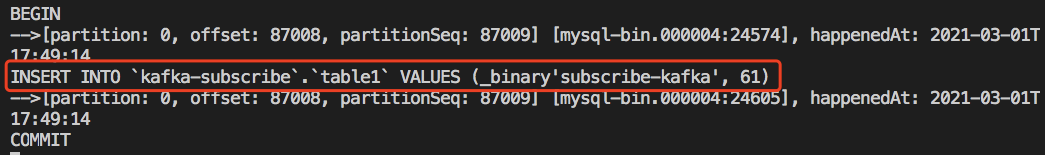
4. 消費状況を観察してください。
Golang Demoの使用説明
コンパイル環境:Golang 1.12以降のバージョン、Go Module環境を設定してください。
操作手順:
1. Golang Demoをダウンロードして、そのファイルを解凍してください。
2. 解凍後のディレクトリに入り、
go build -o consumer ./main/main.goを実行して、実行可能ファイルconsumerを生成します。3. コマンドを実行します。
データ形式としてAvro形式を選択し、以下のコードを実行します:
./consumer --brokers=xxx --topic=xxx --group=xxx --trans2sql=trueデータ形式としてJSON形式を選択し、以下のコードを実行します:
./consumer --brokers=xxx --topic=xxx --group=xxx --trans2sql=trueデータ形式としてCanal ProtoBuf形式を選択し、以下のコードを実行します:
./consumer --brokers=xxx --topic=xxx --group=xxxデータ形式としてCanal JSON形式を選択し、以下のコードを実行します:
./consumer --brokers=xxx --topic=xxx --group=xxx --flatMessage=true各パラメータの詳細説明は以下の通りです:
パラメータ | 説明 |
brokers | CKafkaのアクセスアドレスです。 |
topic | 同期タスクで設定されたtopic名です。 |
group | 消費グループ名です。ユーザーは事前にCkafkaで消費グループを作成できます。ここでカスタム入力することもできます。 |
trans2sql | SQL文に変換するかどうかを示します。Avro、JSON形式を選択した場合に設定が必要です。 |
flatMessage | Canal JSONデータ形式のみを選択する場合に必要です。 |
4. 消費状況を観察してください。
Python3 Demoの使用説明
コンパイル実行環境:Python3、pip3(依存パッケージのインストールに使用)をインストールします。
pip3を使用して依存パッケージをインストールします:
pip install flagpip install kafka-pythonpip install avro
操作手順:
1. Python3 Demoをダウンロードして、そのファイルを解凍してください。
2.
main.pyを実行します。データ形式としてAvro形式を選択し、以下のコードを実行します:
python main.py --brokers=xxx --topic=xxx --group=xxx --trans2sql=1データ形式としてJSON形式を選択し、以下のコードを実行します:
python main.py --brokers=xxx --topic=xxx --group=xxx --trans2sql=1データ形式としてCanal ProtoBuf形式を選択し、以下のコードを実行します:
python main.py --brokers=xxx --topic=xxx --group=xxx データ形式としてCanal JSON形式を選択し、以下のコードを実行します:
python main.py --brokers=xxx --topic=xxx --group=xxx --flatMessage=1各パラメータの詳細説明は以下の通りです:
パラメータ | 説明 |
brokers | CKafkaのアクセスアドレスです。 |
topic | 同期タスクで設定されたtopic名です。 |
group | 消費グループ名です。ユーザーは事前にCkafkaで消費グループを作成できます。ここでカスタム入力することもできます。 |
trans2sql | SQL文に変換するかどうかを示します。1に設定するとSQL文に変換し、0に設定すると変換しません。Avro、JSON形式を選択した場合に設定が必要です。 |
flatMessage | Canal JSONデータ形式のみを選択する場合に必要です。 |
3. 消費状況を観察してください。
フィードバック