データ同期競合ポリシーの選択方法
ダウンロード
フォーカスモード
フォントサイズ
操作シナリオ
DTSは、多対一、一対多、カスケード単方向、双方向同期、カスケード双方向同期などの複雑なトポロジー構造をサポートしています。複雑なトポロジー構造では、複数のノードが同時にデータを書き込むため、PK競合が発生する可能性があります。DTSはPK競合の検出をサポートし、以下のPK競合の処理メカニズムを提供します。
PK競合ポリシー | 説明 | 競合処理時のSQL文書き換え |
競合エラー | 同期タスク中に、ソースデータベースが挿入(INSERT)したPKデータがターゲットデータベースに存在するデータと競合する場合、タスクはエラーを報告して一時停止します。ユーザーが手動で処理した後にのみ続行できます。 | タスクでエラーが発生した場合、SQLの書き換えは行いません。 |
競合を無視 | 同期タスク中に、ソースデータベースのPK挿入(INSERT)データがターゲットデータベースと競合することを検出した場合、ソースデータベースのPK挿入データを無視し、ターゲットデータベースの内容を基準とします。 | INSERTのPK競合時には、INSERTをINSERT IGNOREに書き換えます。 |
競合上書き | 同期タスク中に、ソースデータベースのPK更新(INSERTおよびUPDATE)データがターゲットデータベースと競合することを検出した場合、ソースデータベースのPKデータでターゲットのPKデータを上書きします。 | INSERTのPK競合時には、INSERTをREPLACE INTOに書き換えます。UPDATEのPK競合時には、UPDATEをDELETE + REPLACE INTOに書き換えます。 |
競合ポリシー適用例
PK競合ポリシーは、INSERTのPK競合とUPDATEのPK競合にのみ介入します。その他の競合しないシナリオには介入しません。競合ポリシーを適用すると、タスクがエラーを報告してユーザーに通知するか、または実行を継続できます。以下では、これら2つのPK競合シナリオについて、異なる競合ポリシーを設定した場合の結果を例示します。
INSERT PK競合
A > Bの単方向同期を構築し、IDをPKデータとします。INSERTでPKを挿入した後、データがBに同期される際に競合が発生した場合、DTSは設定された競合ポリシーに従って介入処理を行います。
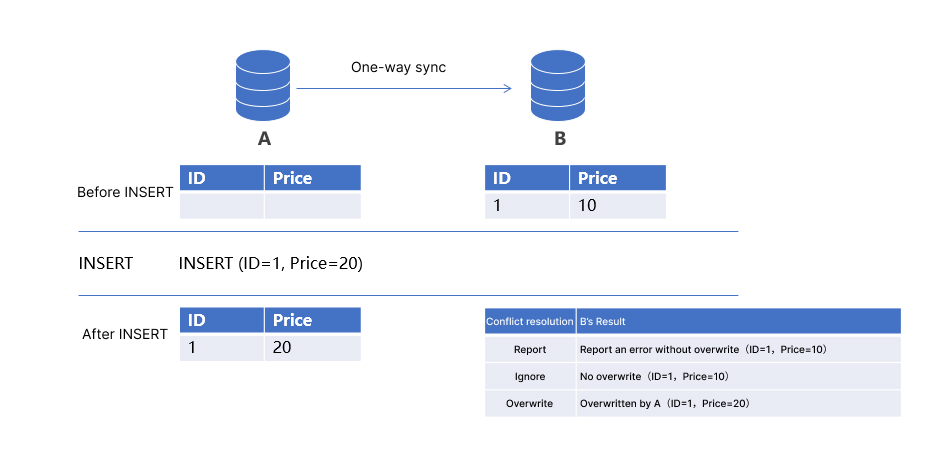
異なる競合ポリシーを設定した場合、最終同期後のB上の結果は以下の通りです。
競合エラー:タスクがエラーを報告し、B上のデータは変更されません(ID=1、Price=10)。
競合無視:AのPKデータを無視し、B上のデータは変更されません(ID=1、Price=10)。
競合上書き:AのPKデータでB上のPKデータを上書きし、B上の結果は(ID=1、Price=20)となります。
UPDATE PK競合
一部のシナリオでは、ユーザーがPKデータを変更することでPK競合が発生する可能性があります。例えば、A上でPKをUPDATEした後(ID=1 -> ID=2)、B上に元々存在するIDが2のPKデータと競合します。
異なる競合ポリシーを設定した場合、最終同期後のB上の結果は以下の通りです。
競合エラー:タスクがエラーを報告し、B上のデータは変更されません。
競合無視:タスクがエラーを報告し、B上のデータは変更されません。特に、この場合DTSは介入を行いません。
競合上書き:AのPKデータでB上のPKデータを上書きし、B上には主キーが2のデータのみが存在します(ID=2、Price=10)。
競合ポリシーとデータ整合性
两地三センター、異地マルチアクティブなどの複雑なデータアーキテクチャでは、3つ以上のノードが同時にデータを書き込む必要があり、複数ノードの一貫性を確保することが非常に重要です。多くのユーザーは、PK競合ポリシーによってデータが特定のノードを基準に更新されることを保証できると誤解していますが、これは合理的ではありません。
例えば、下図の双方向同期シナリオでは、A > B、B > Aの両方が競合上書きに設定されています。A、Bノード上で同時にPKが1のデータをINSERTすると、最終的にA、B上のPK 1のデータが交換されます。
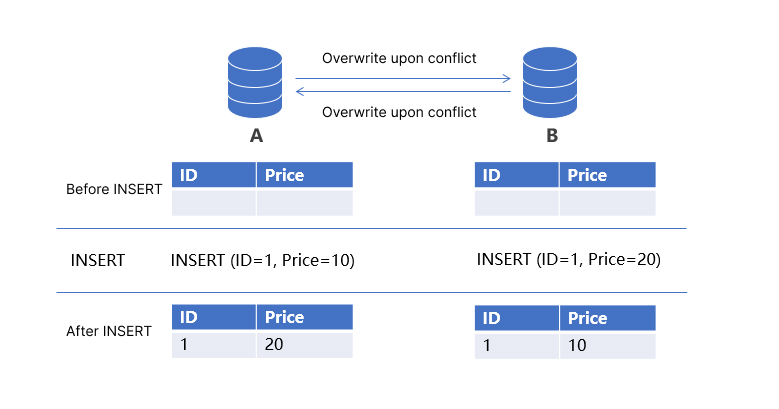
実際のシナリオで複数ノードのデータ一貫性を実現するには、一般的にPKパーティションの分割、追加の調整メカニズムの導入(例えば、データにバージョン番号を追加し、バージョン番号による上書きメカニズムを実装する)などの方法が必要です。競合ポリシーだけではこの要件を達成できません。
フィードバック