データ消費操作ガイド
ダウンロード
フォーカスモード
フォントサイズ
操作シナリオ
データをKafkaに同期した後、0.11バージョン以上のKafkaクライアントを使用してサブスクリプションデータを消費できます。このドキュメントでは、Java、Go、Python言語のクライアント消費Demoサンプルを提供しており、データ消費のプロセスを迅速にテストし、データ形式の解析方法を理解するのに役立ちます。
注意事項
1. Demoにはデータ消費の使用方法のデモは含まれておらず、データの印刷処理のみが行われています。お客様はこれに基づいてデータ処理ロジックを自身で作成する必要があります。他の言語のKafkaクライアントを使用してデータを消費し、解析することもできます。
2. ターゲットCkafkaで設定するメッセージサイズの上限は、ソースデータベースのテーブル内の単一行データの最大値より大きくする必要があります。これにより、データを正常にターゲット側へ同期できます。
3. 指定のデータベース/テーブルオブジェクト(ソースインスタンス全体ではない)を同期し、かつKafka単一パーティションを使用するシナリオでは、DTSが増分データを解析した後、同期オブジェクトのデータのみをKafka Topicに書き込みます。その他の非同期オブジェクトのデータは空のトランザクションに変換されてKafka Topicに書き込まれるため、データを消費する際に空のトランザクションが発生します。空のトランザクションのBegin/CommitメッセージにはトランザクションのGTID情報が保持されており、GTIDの連続性と完全性を保証できます。また、MySQL/TDSQL-C MySQLの消費Demoでは、複数の空のトランザクションも圧縮処理され、メッセージ数が削減されます。
4. データの再入可能性を保証するために、DTSからKafkaへの同期リンクにCheckpointメカニズムが導入されています。メッセージがKafka Topicに書き込まれる際、通常10秒ごとにCheckpointが1つ挿入され、データ同期の位置を識別するために使用されます。タスクが中断された後に再起動すると、中断位置を認識して再開できます。また、コンシューマー側はCheckpointメッセージを受信すると、Kafkaの消費場所のコミットを一度実行し、消費場所をタイムリーに更新します。
5. データ形式にJSONを選択した場合、オープンソースの購読ツールCanalを使用したことがあるか、または熟知している場合は、ここで消費されたJSON形式のデータをCanalツール互換のデータ形式に変換してから後続の処理を行うことができます。私たちのDemoではすでに関連サポートを提供しており、Demoを起動する際のパラメータにtrans2canalを追加するだけで実現できます。現在、この機能はJava言語のみでサポートされています。
Demoのダウンロードを消費
同期タスクの設定では、AvroとJSONの異なるデータ形式を選択できます。Avroはバイナリ形式を採用しており、消費効率がより高くなります。JSONは軽量なテキスト形式を採用しており、より簡単に使用できます。選択したデータ形式が異なると、参照するDemoサンプルも異なります。
以下に提供するDemo例には、対応するAvro/JSONプロトコルファイルがすべて含まれているため、別途ダウンロードする必要はありません。
Demoのロジック説明および主要パラメータの説明については、Demo説明を参照してください。
Java Demoの使用説明
コンパイル環境:MavenまたはGradleパッケージ管理ツール、JDK8。ユーザーはパッケージツールを自身で選択できます。以下ではMavenを例として説明します。
操作手順:
1. Java Demoをダウンロードして、そのファイルを解凍してください。
2. 解凍後のディレクトリに入ります。利用しやすいように、ディレクトリにはMavenモデルファイルとpom.xmlファイルがそれぞれ配置されています。ユーザーは必要に応じて選択してください。
Mavenを使用してパッケージングします:mvn clean package。
3. Demoを実行します。
Mavenでパッケージングした後、ターゲットフォルダtargetに入り、以下のコードを実行します:
java -jar consumerDemo-avro-1.0-SNAPSHOT.jar --brokers xxx --topic xxx --group xxx --trans2sqlbrokersはCKafkaのアクセスアドレスです。topicは同期タスクで設定したtopic名です。複数のtopicがある場合はそれぞれ消費する必要があります。この2つはデータ同期 > 操作 > 表示から取得できます。groupはコンシューマグループ名です。ユーザーは事前にCkafkaでコンシューマグループを作成することも、ここでカスタム入力することもできます。trans2sqlはSQL文に変換するかどうかを示します。javaコードでは、このパラメータを指定するとSQL文に変換され、指定しない場合は変換されません。trans2canalはCanal形式に変換して出力するかどうかを示します。このパラメータを指定するとCanal形式に変換され、指定しない場合は変換されません。説明:
trans2sqlを指定する場合、
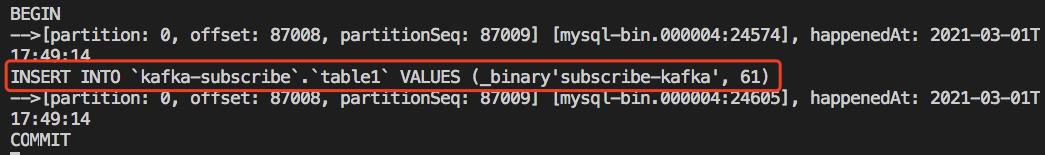
javax.xml.bind.DatatypeConverter.printHexBinary()を使用してbyte値を16進数に変換します。非互換性を避けるため、JDK1.8以降のバージョンを使用してください。SQLに変換する必要がない場合は、ここのコードをコメントアウトできます。4. 消費状況を観察してください。
Golang Demoの使用説明
コンパイル環境:Golang 1.12以降のバージョン、Go Module環境を設定してください。
操作手順:
1. Golang Demoをダウンロードして、そのファイルを解凍してください。
2. 解凍後のディレクトリに入り、
go build -o subscribe ./main/main.goを実行して、実行可能ファイルsubscribeを生成します。3.
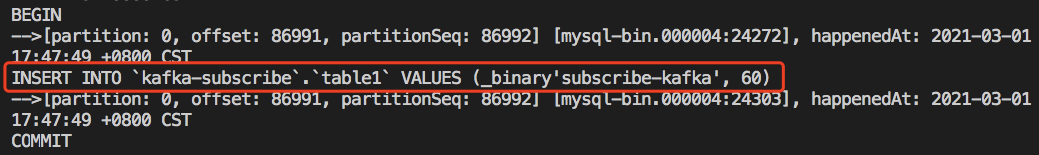
./subscribe --brokers=xxx --topic=xxx --group=xxx --trans2sql=trueを実行します。brokersはCKafkaのアクセスアドレスです。topicは同期タスクで設定したtopic名です。複数のtopicがある場合はそれぞれ消費する必要があります。この2つはデータ同期>操作>表示から取得できます。groupはコンシューマグループ名です。ユーザーは事前にCkafkaでコンシューマグループを作成することも、ここでカスタム入力することもできます。trans2sqlはSQL文に変換するかどうかを示します。4. 消費状況を観察してください。
Python3 Demoの使用説明
コンパイル実行環境:Python3、pip3(依存パッケージのインストールに使用)をインストールします。
pip3を使用して依存パッケージをインストールします:
pip install flagpip install kafka-pythonpip install avro
操作手順:
1. Python3 Demoをダウンロードして、そのファイルを解凍してください。
2.
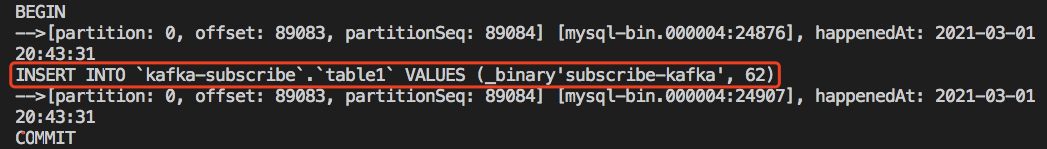
python main.py --brokers=xxx --topic=xxx --group=xxx --trans2sql=1を実行します。brokersはCKafkaのアクセスアドレスです。topicは同期タスクで設定したtopic名です。複数のtopicがある場合はそれぞれ消費する必要があります。この2つはデータ同期 > 操作 > 表示から取得できます。groupはコンシューマグループ名です。ユーザーは事前にCkafkaでコンシューマグループを作成することも、ここでカスタム入力することもできます。trans2sqlはSQL文に変換するかどうかを示します。3. 消費状況を観察してください。
フィードバック