Protobuf Demo 説明(Flink)
ダウンロード
フォーカスモード
フォントサイズ
デモの主要ロジック解説
メッセージ生成ロジック
以下では、まずメッセージ生成ロジックについて簡単に説明します。これはユーザーが消費ロジックを理解するのに役立ちます。
私たちは Protobuf を使用してシリアル化を行い、各言語の Demo には Protobuf 定義ファイルが付属しています。ファイルにはいくつかの重要な構造が定義されています:Envelope は最終的に送信される Kafka メッセージ構造です。Entry は単一のサブスクリプションイベント構造です。Entries は Entry の集合です。主要なデータ構造の関係は以下の通りです:
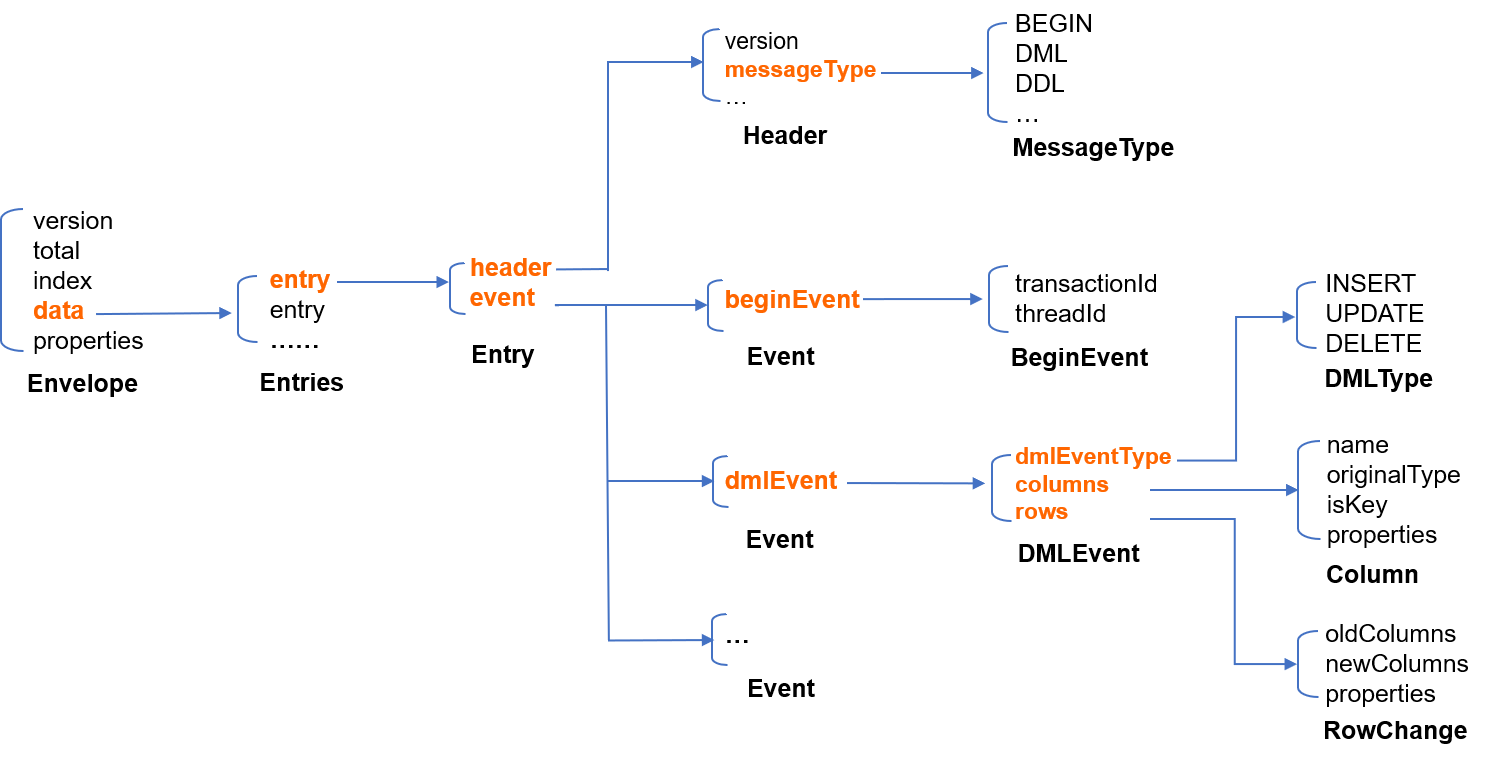
生産プロセスは以下の通りです:
1. Binlogメッセージを取得し、各Binlog Eventを1つのEntry構造体にエンコードします。
message Entry { //Entryは単一のサブスクリプションイベント構造です。1つのイベントはMySQLの1つのbinlog eventに相当します。Header header = 1; //イベントヘッダーEvent event = 2; //イベントボディ}message Header {int32 version = 1; //EntryプロトコルバージョンSourceType sourceType = 2; //ソースデータベースのタイプ情報。MySQL、Oracleなどのタイプが含まれます。MessageType messageType = 3; //メッセージのタイプ、つまりEventのタイプです。BEGIN、COMMIT、DMLなどが含まれます。uint32 timestamp = 4; //Eventの元のbinlogにおけるタイムスタンプint64 serverId = 5; //ソースのserverIdstring fileName = 6; //ソースbinlogのファイル名uint64 position = 7; //ソースbinlogファイル内のイベントのオフセットstring gtid = 8; //現在のトランザクションのgtidstring schemaName = 9; //変更の影響を受けるスキーマstring tableName = 10; //変更の影響を受けるテーブルuint64 seqId = 11; //グローバル増分シーケンス番号uint64 eventIndex = 12; //大きなeventをシャード化する場合、各シャードは0から番号が振られます。現在のバージョンでは意味がなく、今後の拡張用に予約されています。bool isLast = 13; //現在のeventがeventシャードの最後のブロックであるかどうか。最後のブロックである場合はtrueです。現在のバージョンでは意味がなく、今後の拡張用に予約されています。repeated KVPair properties = 15;}message Event {BeginEvent beginEvent = 1; //binlog内のbeginイベントDMLEvent dmlEvent = 2; //binlog内のdmlイベントCommitEvent commitEvent = 3; //binlog内のcommitイベントDDLEvent ddlEvent = 4; //binlog内のddlイベントRollbackEvent rollbackEvent = 5; //rollbackイベント。現在のバージョンでは意味がありません。HeartbeatEvent heartbeatEvent = 6; //ソースデータベースが定期的に送信するハートビートイベントCheckpointEvent checkpointEvent = 7; //購読バックエンドが追加するcheckpointイベントです。10秒ごとに1つ自動生成され、Kafkaの生産および消費場所の管理に使用されます。repeated KVPair properties = 15;}
2. メッセージ量を削減するために、複数の Entry をマージします。マージ後の構造は Entries であり、Entries.items フィールドは Entry の順序リストです。マージの数は、マージ後に Kafka の単一メッセージサイズ制限を超えないことを基準とします。単一の Event がすでにサイズ制限を超えている場合は、マージせず、Entries には唯一の Entry のみが含まれます。
message Entries {repeated Entry items = 1; //entry list}
3. Entries に対して Protobuf エンコードを行い、バイナリシーケンスを取得します。
4. Entries のバイナリシーケンスを Envelope の data フィールドに格納します。単一の Binlog Event が大きすぎる場合、バイナリシーケンスが Kafka の単一メッセージサイズ制限を超える可能性があります。その場合、複数のセグメントに分割し、各セグメントを1つの Envelope に格納します。
message Envelope {int32 version = 1; //プロトコルバージョン。data内容のデコード方法を決定します。uint32 total = 2;uint32 index = 3;bytes data = 4; //現在のversionが1の場合、data内のデータはEntriesがPBシリアル化された結果であることを示します。repeated KVPair properties = 15;}
5. 前のステップで生成された1つまたは複数の Envelope に対して順次 Protobuf エンコードを行い、Kafka パーティションに配信します。同じ Entries から分割された複数の Envelope は、順番に同じパーティションに配信されます。
メッセージ消費ロジック
以下では、消費ロジックについて簡単に説明します。
1. Flink コンシューマー側では、FlinkKafkaConsumer を作成し、消費トピックを指定し、Protobuf プロトコルに基づくメッセージデシリアライザをカスタマイズする必要があります。
// Flink-kafka コンシューマーを作成します。FlinkKafkaConsumer<RecordMsgObject> consumer =new FlinkKafkaConsumer<>(topic, new DeserializeProtobufToRecordMsgObject(), props);
2. DeserializeProtobufToRecordMsgObject は元のメッセージを RecordMsgObject オブジェクトにデシリアライズします。
// カスタムデシリアライザ。元のメッセージを RecordMsgObject オブジェクトにデシリアライズします。@Overridepublic RecordMsgObject deserialize(ConsumerRecord<byte[], byte[]> record) throws Exception {RecordMsgObject obj = new RecordMsgObject();obj.topic = record.topic();obj.partition = record.partition();obj.offset = record.offset();obj.partitionSeq = getPartitionSeq(record);obj.key = new String(record.key());obj.headers = record.headers();// ここで受信されるのは Envelope のバイナリ値です。obj.value = record.value();return obj;}
3. 受信したメッセージをメッセージの partition ごとにグループ化して処理します。グループ化処理ロジックは SubscribeMsgProcess によって実装されます。
//受信したメッセージを partition ごとに処理します。stream.keyBy(RecordMsgObject::getPartition).process(new SubscribeMsgProcess(trans2sql)).setParallelism(1);
4. SubscribeMsgProcess では、受信したバイナリシーケンスを Protobuf で Envelope にデコードします。
// envlope をデシリアライズします。このデモでは、デフォルトで1つの envlope に bnlog-event の全データを格納できます。SubscribeProtobufData.Envelope envelope = SubscribeProtobufData.Envelope.parseFrom(record.value);if (1 != envelope.getVersion()) {throw new IllegalStateException(String.format("unsupported version: %d", envelope.getVersion()));}
注意:
本デモでは、デフォルトで単一の Binlog Event が Kafka の単一メッセージサイズ制限を超えないことを前提としています。単一メッセージサイズ制限を超える場合、デモでは消費時に Flink の高度な機能である「状態」を導入して Envelope を結合し、完全なメッセージ本体を取得する必要があります。このようなシナリオでは、ユーザーは Flink 公式サイト を参照し、自身のビジネスシナリオに応じて処理する必要があります。
5. 受信した Envelope の data フィールドのバイナリシーケンスを Protobuf で Entries にデコードします。
// デシリアライズして Entries を取得します。ByteString envelopeData = envelope.getData();SubscribeProtobufData.Entries entries;if (1 == envelope.getTotal()) {entries = SubscribeProtobufData.Entries.parseFrom(envelopeData.toByteArray());} else {entries = SubscribeProtobufData.Entries.parseFrom(shardMsgMap.get(shardId).toByteArray());shardMsgMap.remove(shardId);}
6. Entries.items を順次処理し、元の Entry 構造を出力するか、SQL 文に変換します。
// 各 Entry を順に処理し、Entry のタイプに応じて sql を出力します。for (SubscribeProtobufData.Entry entry : entries.getItemsList()) {onEntry(record.partition, record.offset, ps, entry, trans2sql);}
Table API & Flink SQL
本デモでは、クライアントタイプが DataStream API のモードのみを示しています。Flink のクライアントモードが Table API & Flink SQL のシナリオは、ユーザーが自身で処理する必要があります。Table API & Flink SQL を使用するクライアントモードには2つの方法があります:
1. DataStream を Table に変換するクライアント形式を使用します。詳細については、DataStream API Integration を参照してください。
2. Table API & Flink SQL に基づいて connector をカスタマイズします。詳細については、User-defined Sources & Sinks を参照してください。
データベースフィールドマッピングとストレージ
本节では、データベースのフィールドタイプとシリアライゼーションプロトコルで定義されたデータタイプとの間のマッピング関係を説明します。
ソースデータベースのフィールド値は、Protobuf プロトコルにおいて以下の Data 構造で保存されます。
message Data {DataType dataType = 1;string charset = 2; //DataType_STRING のエンコーディングタイプ。値は bv に格納されます。string sv = 3; //DataType_INT8/16/32/64/UINT8/16/32/64/Float32/64/DataType_DECIMAL の文字列値。bytes bv = 4; //DataType_STRING/DataType_BYTES の値。}
DataType フィールドは保存されるフィールドタイプを表し、取り得る列挙値は以下の図の通りです。
enum DataType {NIL = 0; //値は NULL です。INT8 = 1;INT16 = 2;INT32 = 3;INT64 = 4;UINT8 = 5;UINT16 = 6;UINT32 = 7;UINT64 = 8;FLOAT32 = 9;FLOAT64 = 10;BYTES = 11;DECIMAL = 12;STRING = 13;NA = 14; //値は存在しません (N/A)}
このうち、bv フィールドは STRING および BYTES タイプのバイナリ表現を格納し、sv フィールドは INT8/16/32/64/UINT8/16/32/64/DECIMAL タイプの文字列表現を格納し、charset フィールドは STRING のエンコーディングタイプを格納します。
TDSQL MySQL の元のタイプと DataType のマッピング関係は以下の通りです(UNSIGNED で修飾された MYSQL_TYPE_INT8/16/24/32/64 は、それぞれ UINT8/16/32/32/64 にマッピングされます):
説明:
DATE、TIME、DATETIME タイプはタイムゾーンをサポートしていません。TIMESTAMP タイプはタイムゾーンをサポートします。このタイプのフィールドは、保存時にシステムが現在のタイムゾーンから UTC(Universal Time Coordinated)に変換して保存し、クエリ時にシステムが UTC から現在のタイムゾーンに変換してクエリすることを示します。以上をまとめると、以下の表の「MYSQL_TYPE_TIMESTAMP」および「MYSQL_TYPE_TIMESTAMP_NEW」フィールドにはタイムゾーン情報が含まれます。ユーザーはデータを消費する際に自身で変換できます。(例えば、DTS が出力する時刻形式はタイムゾーン付きの文字列「2021-05-17 07:22:42 +00:00」です。このうち、「+00:00」は UTC 時間を表し、ユーザーは解析および変換の際にタイムゾーン情報を考慮する必要があります。)
TDSQL MySQLフィールドタイプ | 対応する Protobuf DataType 列挙値 |
MYSQL_TYPE_NULL | NIL |
MYSQL_TYPE_INT8 | INT8 |
MYSQL_TYPE_INT16 | INT16 |
MYSQL_TYPE_INT24 | INT32 |
MYSQL_TYPE_INT32 | INT32 |
MYSQL_TYPE_INT64 | INT64 |
MYSQL_TYPE_BIT | INT64 |
MYSQL_TYPE_YEAR | INT64 |
MYSQL_TYPE_FLOAT | FLOAT32 |
MYSQL_TYPE_DOUBLE | FLOAT64 |
MYSQL_TYPE_VARCHAR | STRING |
MYSQL_TYPE_STRING | STRING |
MYSQL_TYPE_VAR_STRING | STRING |
MYSQL_TYPE_TIMESTAMP | STRING |
MYSQL_TYPE_DATE | STRING |
MYSQL_TYPE_TIME | STRING |
MYSQL_TYPE_DATETIME | STRING |
MYSQL_TYPE_TIMESTAMP_NEW | STRING |
MYSQL_TYPE_DATE_NEW | STRING |
MYSQL_TYPE_TIME_NEW | STRNG |
MYSQL_TYPE_DATETIME_NEW | STRING |
MYSQL_TYPE_ENUM | STRING |
MYSQL_TYPE_SET | STRING |
MYSQL_TYPE_DECIMAL | DECIMAL |
MYSQL_TYPE_DECIMAL_NEW | DECIMAL |
MYSQL_TYPE_JSON | BYTES |
MYSQL_TYPE_BLOB | BYTES |
MYSQL_TYPE_TINY_BLOB | BYTES |
MYSQL_TYPE_MEDIUM_BLOB | BYTES |
MYSQL_TYPE_LONG_BLOB | BYTES |
MYSQL_TYPE_GEOMETRY | BYTES |
フィードバック