エンリッチメント関数
ダウンロード
フォーカスモード
フォントサイズ
t_table_map関数
関数定義
ターゲットテーブルとマッピングし、入力されたフィールド名に基づいてフィールド値を返します。簡単に言えば、ログとディメンションテーブルの関連付けと理解できます。
構文記述
t_table_map(data, field, output_fields, missing=None, mode="fill-auto")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
data | ターゲットテーブル(ディメンションテーブル) | table | はい | - | - |
field | ログ内でテーブルにマッピングされるソースフィールドです。ログに対応するフィールドが存在しない場合、何も実行されません。String および String List をサポートします。 | any | はい | - | - |
output_fields | マッピング後のフィールドです。例えば、["province", "pop"]です。String および String List をサポートします。 | any | はい | - | - |
missing | 一致するフィールドがない場合、このパラメータの値を出力フィールド output_fields に割り当てます。 | String | いいえ | - | - |
mode | フィールドの上書きモードです。デフォルトは fill-auto です。 | String | いいえ | fill-auto |
例
例1:MySQLから複数の新しいフィールドをエンリッチメント
MySQLでテーブルtestを新規作成し、以下のデータを追加します:
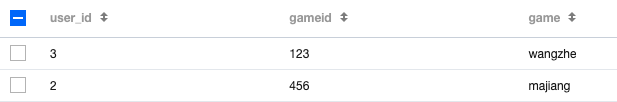
元のログ:
[{"user_id": 1},{"user_id": 3}]
加工ルール:
res_rds_mysqlはMySQLからディメンションテーブルデータを取得するために使用されます。
//コンソールで外部データMySQLのエイリアスをhmに設定し、MySQLのdbをtest222、テーブル名をtestにします。//MySQLから全データを取得し、t_table_map関数を使用してディメンションテーブル関連付けを実行します。t_table_map(res_rds_mysql(alias="hm",database="test222",sql="select * from test"),"user_id",["gameid", "game"])
加工結果:
[{"user_id":"1"},{"game":"wangzhe","gameid":"123","user_id":"3"}]
例2:関連フィールド名が異なる場合、エンリッチメントフィールドの名前を変更
ログフィールドPidとMySQLのidフィールドは関連付けられており、名称が異なります。MySQLからエンリッチされたgame_detailsフィールドは、ログ内でgame_infoに名前が変更されます。
MySQLでテーブルtestを新規作成し、以下のデータを追加します:
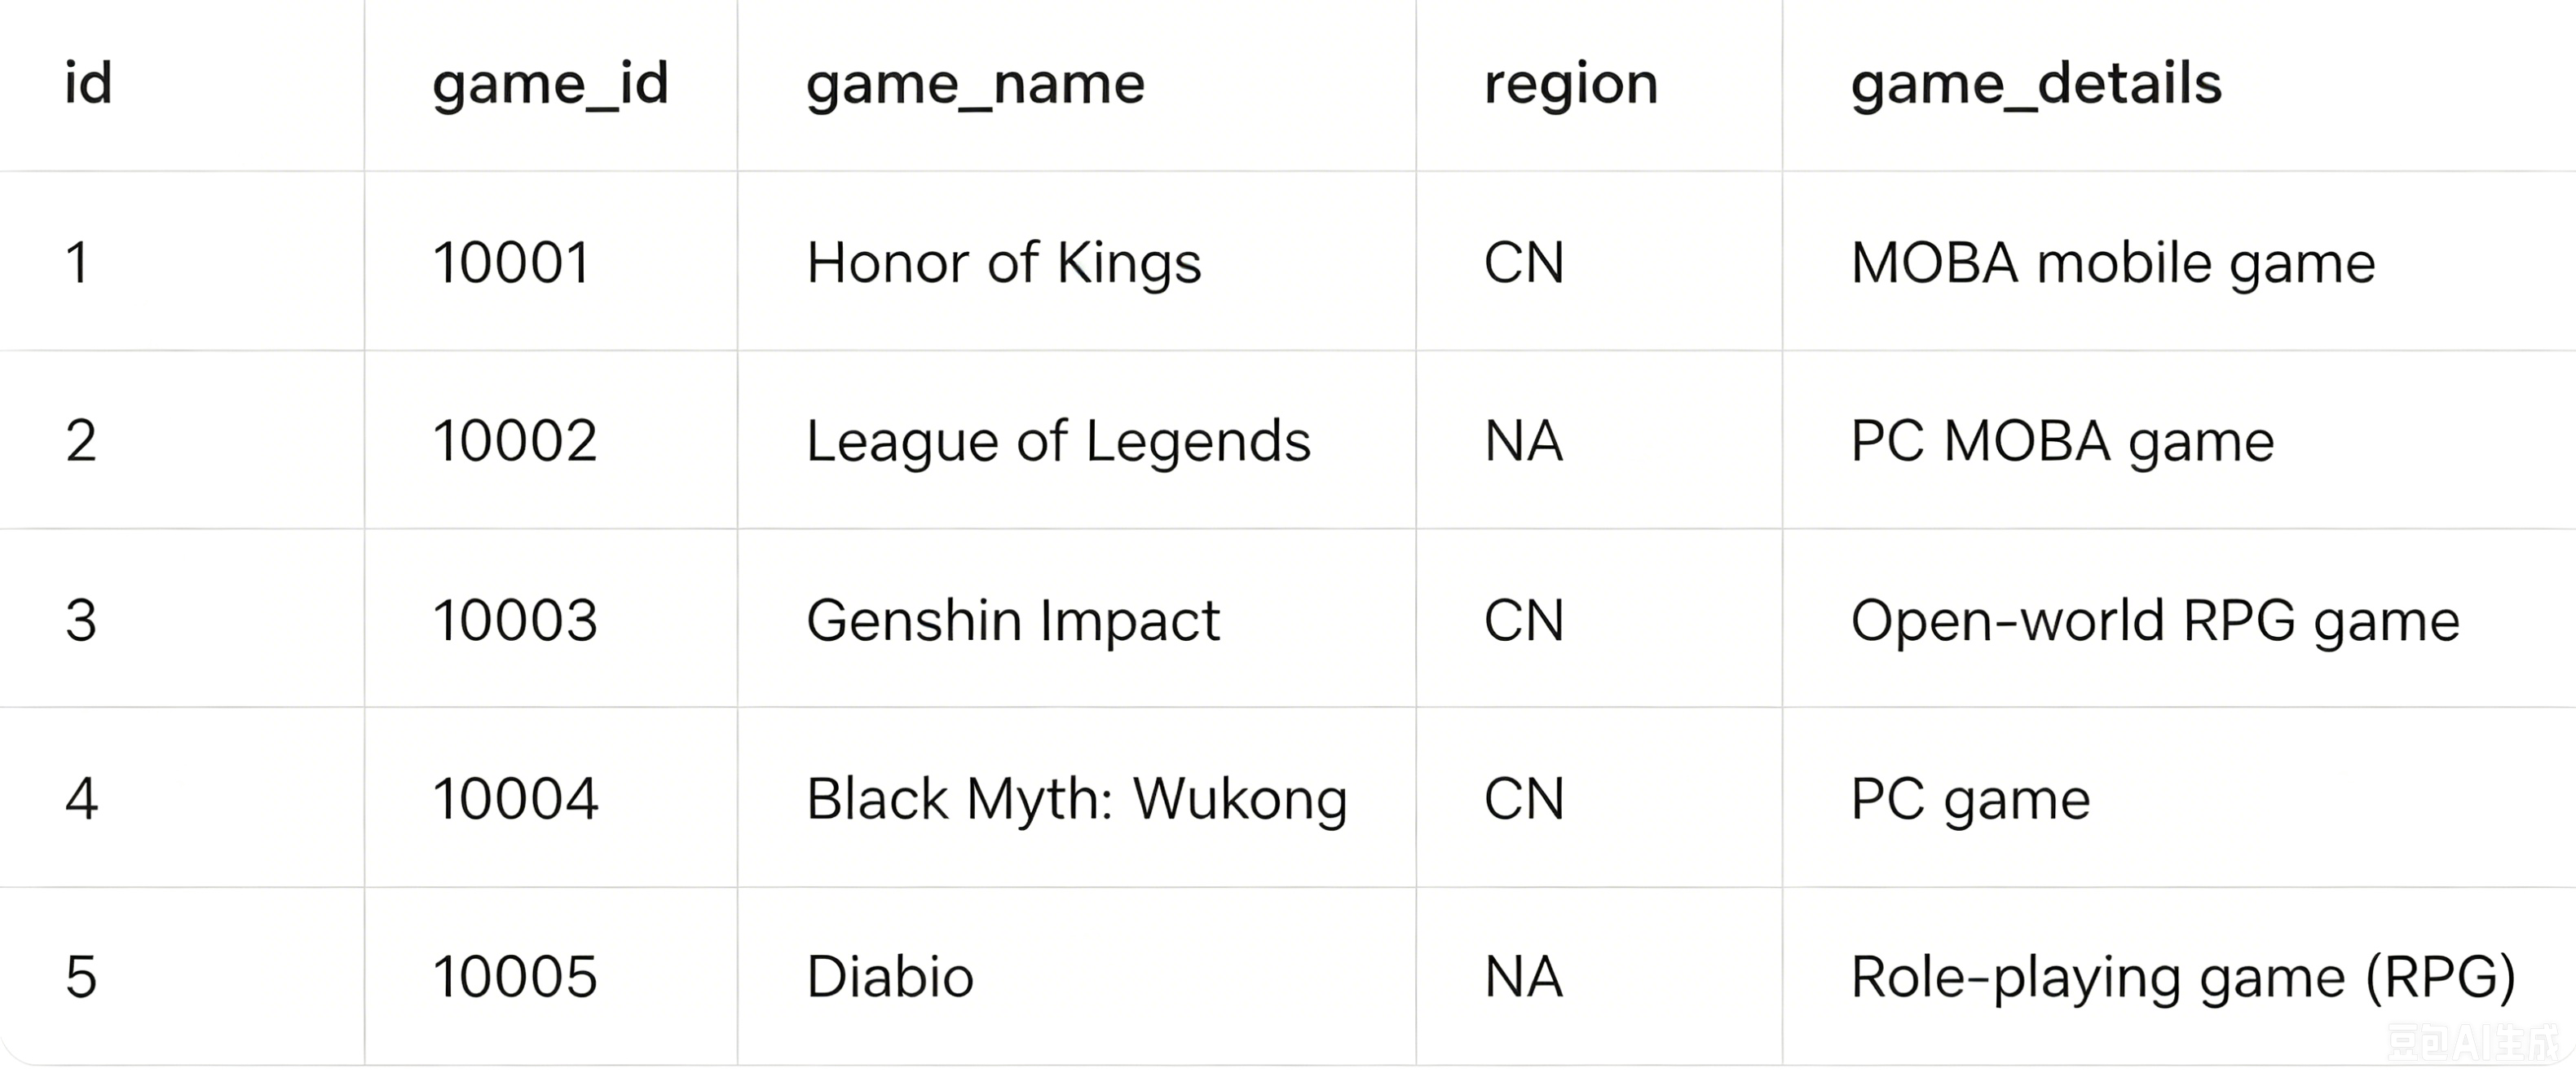
元のログ:
[{"Pid": 1},{"Pid": 2},{"Pid": 3}]
加工ルール:
//コンソールで外部データMySQLのエイリアスをhmに設定し、MySQLのdbをtest222、テーブル名をtestにします。//MySQLから一部のデータを取得し、t_table_map関数を使用してディメンションテーブル関連付けを実行します。//ログフィールドPidとMySQLのidフィールドは関連付けられており、名称が異なります。//MySQLからエンリッチされたgame_detailsフィールドは、ログ内でgame_infoに名前が変更されます。t_table_map(res_rds_mysql(alias="hm",database="test222",sql="select * from test where region='CN'"),[["Pid", "id"]],["game_name",["game_details","game_info"]])
加工結果:
[{"Pid":"1""game_info":"MOBAモバイルゲーム""game_name":"王者栄耀"},{"Pid":"2"},{"Pid":"3""game_info":"オープンワールドRPGゲーム""game_name":"原神"}]
enrich_table関数
関数定義
CSV構造データを使用してログ内のフィールドをマッチングし、値が同じ場合、CSV内の他のフィールドと値をソースログに追加できます。
構文記述
enrich_table("csvソースデータ", "csvエンリッチフィールド", output="ターゲットフィールド1、ターゲットフィールド2、ターゲットフィールド....", mode="overwrite")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
data | 入力されたCSVデータは、1行目が列名で、その他の行は値に対応します。例えば:region,count\\nbj, 200\\ngz, 300 | String | はい | - | - |
fields | マッチング対象列名。CSV内のフィールド名で、実際のログ内の同名フィールドとマッチングします。単一フィールド名、または半角カンマで連結された複数の新規フィールド名です。 | String | はい | - | - |
output | 出力フィールドリスト、単一のフィールド名、または英語の半角カンマで連結された複数の新しいフィールド名 | String | はい | - | - |
mode | 新規フィールドの書き込みモードです。デフォルトでは強制上書きされます。 | String | いいえ | overwrite | - |
例
元のログ:
{"region": "gz"}
加工ルール:
enrich_table("region,count\\nbj,200\\ngz,300", "region", output="count")
加工結果:
{"count":"300","region":"gz"}
enrich_dict関数
関数定義
Dict構造を使用してログ内のフィールド値をマッチングし、指定されたフィールドの値がDict内のKeyと同じ場合、このKeyに対応するValueをログ内の別のフィールドに代入します。
構文記述
enrich_dict("JSON辞書", "ソースフィールド名", output=ターゲットフィールド, mode="overwrite")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
data | 入力されたdictデータです。ここではJSONオブジェクトのエスケープ文字列である必要があります。例えば:{\\"200\\":\\"SUCCESS\\",\\"500\\":\\"FAILED\\"} | String | はい | - | - |
fields | マッチング対象フィールド名です。dict内のkeyと指定されたフィールドに対応する値が同じ場合、マッチングは成功します。単一のフィールド名、または英語の半角カンマで連結された複数の新しいフィールド名です。 | String | はい | - | - |
output | ターゲットフィールドリストです。マッチング成功後、dict内の対応するvalueをターゲットフィールドリストに書き込みます。単一のフィールド名、または英語の半角カンマで連結された複数の新しいフィールド名です。 | String | はい | - | - |
mode | 新規フィールドの書き込みモードです。デフォルトでは強制上書きされます。 | String | いいえ | overwrite |
例
元のログ:
{"status": "500"}
加工ルール:
enrich_dict("{\\"200\\":\\"SUCCESS\\",\\"500\\":\\"FAILED\\"}", "status", output="message")
加工結果:
{"message":"FAILED","status":"500"}
フィードバック