キー値抽出関数
ダウンロード
フォーカスモード
フォントサイズ
概要
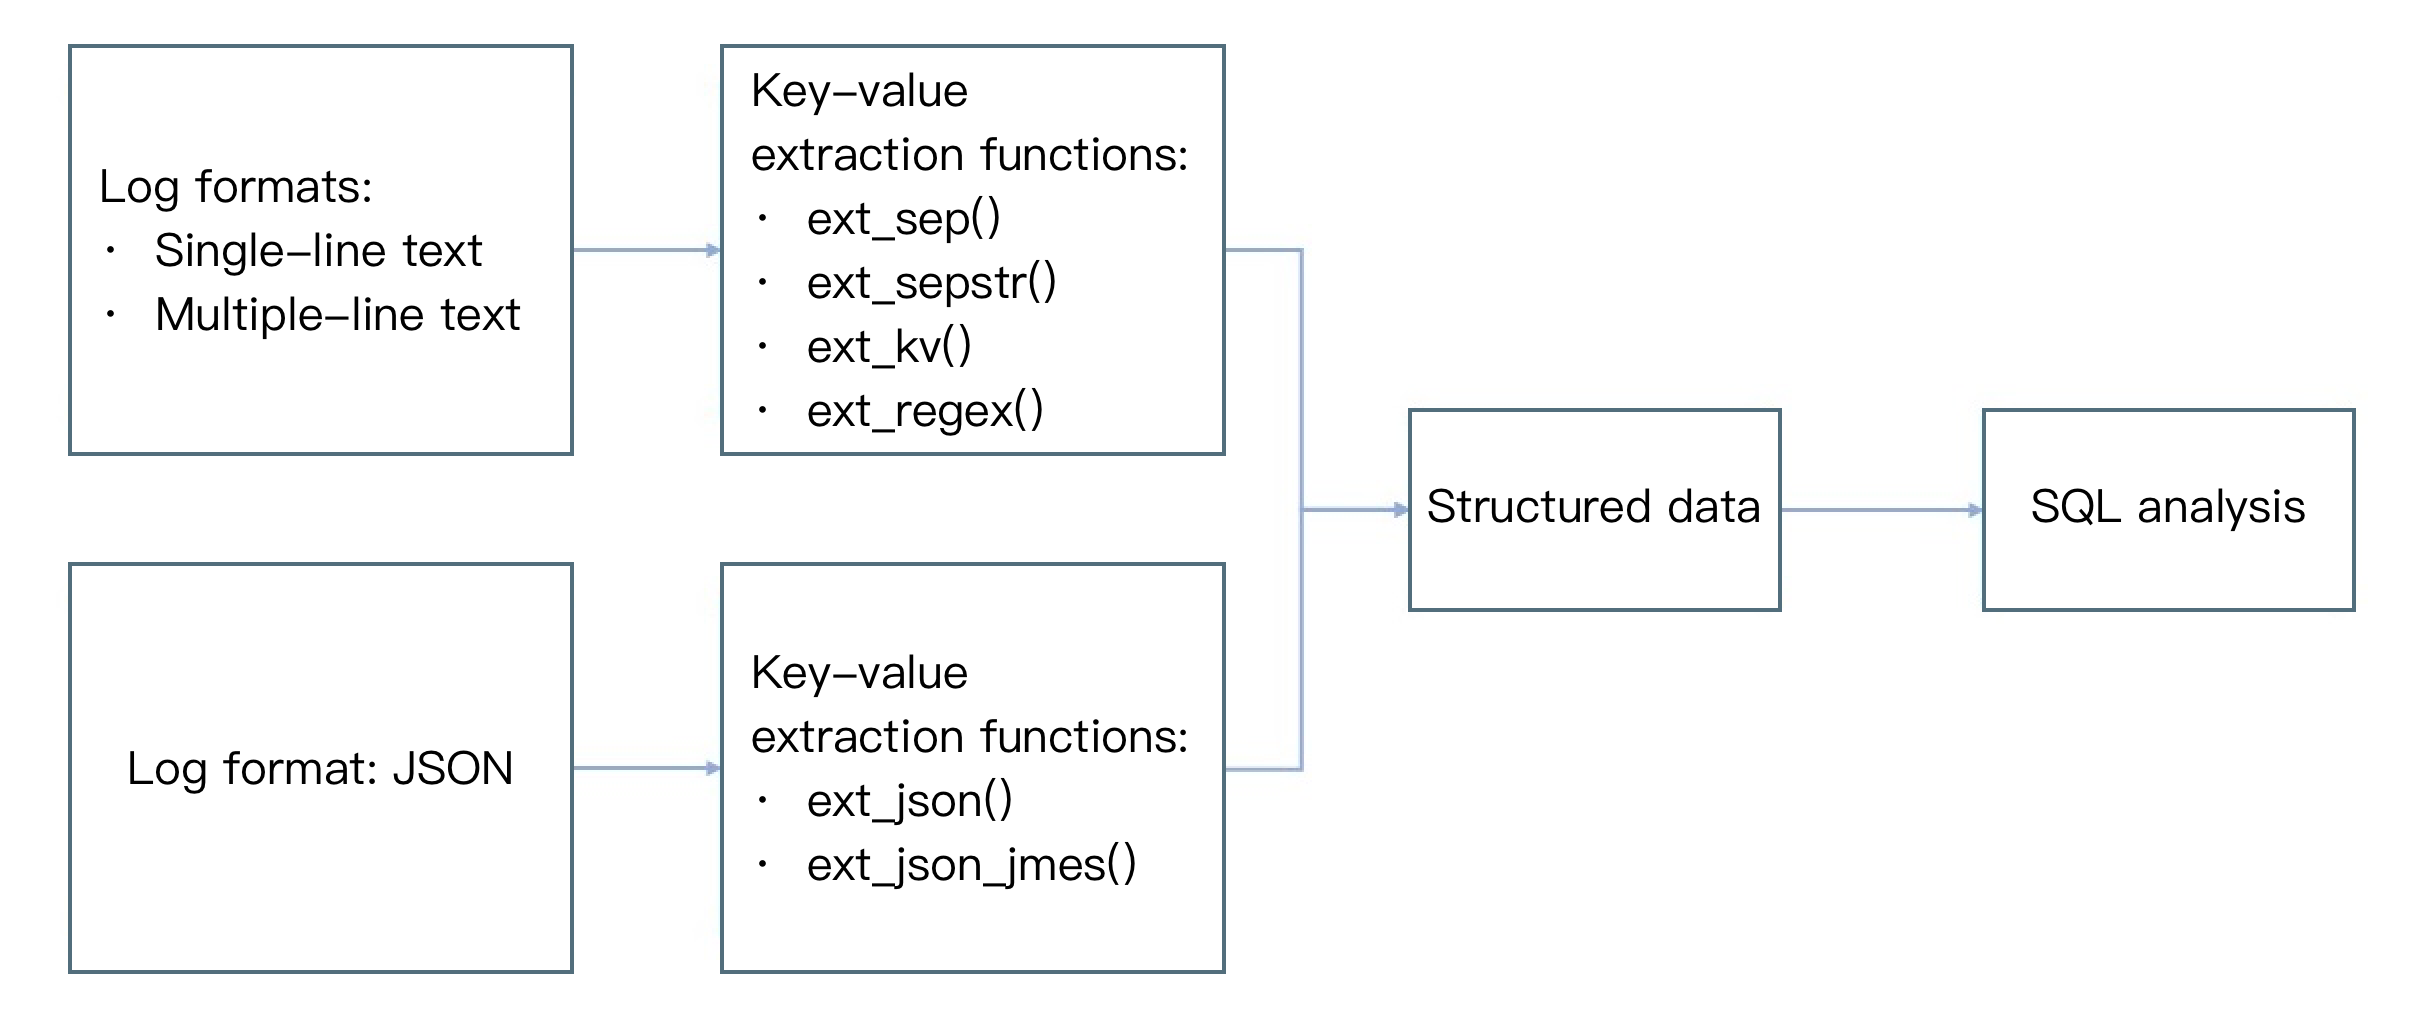
键值提取関数の一般的な使用シナリオは下図の通りです。構造化データに処理した後、さらにSQL分析のシナリオに使用できます。
ext_sep() 関数
関数定義
区切り文字(単一文字)に基づいてフィールド値の内容を抽出します。
構文記述
ext_sep("ソースフィールド名", "ターゲットフィールド1,ターゲットフィールド2,ターゲットフィールド...", sep="区切り文字", quote="分割対象外の部分", restrict=False, mode="overwrite")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | ユーザーログに既に存在するフィールド名 |
output | 単一のフィールド名、または半角カンマで連結された複数の新しいフィールド名 | string | はい | - | - |
sep | 区切り文字 | string | いいえ | , | 任意の単一文字 |
quote | 値を囲む文字 | string | いいえ | - | - |
restrict | デフォルトはFalseです。抽出された値の数がユーザーが入力した対象フィールド数と一致しない場合: True:無視し、いかなる抽出処理も行いません。 False:可能な限り先頭のいくつかのフィールドに一致させます。 | bool | いいえ | False | - |
mode | 新しいフィールドの書き込みモードです。デフォルトでは強制的に上書きします。 | string | いいえ | overwrite |
例
例1:カンマを区切り文字として使用し、ログ内の値を抽出します。
元のログ:
{"content": "hello Go,hello Java,hello python"}
加工ルール:
//カンマを区切り文字として使用し、contentフィールド値を3つのセグメントに分割し、それぞれf1、f2、f3の3つのフィールドに対応させます。ext_sep("content", "f1, f2, f3", sep=",", quote="", restrict=False, mode="overwrite")//contentフィールドを破棄します。fields_drop("content")
加工結果:
{"f1":"hello Go","f2":"hello Java","f3":"hello python"}
例2:quoteを使用して文字列を全体として処理します。
元のログ:
{"content": " Go,%hello ,Java%,python"}
加工ルール:
ext_sep("content", "f1, f2", quote="%", restrict=False)
加工結果:
//%hello ,Java%にはカンマが含まれていますが、全体として扱われるため、区切り文字の抽出には関与しません。{"content":" Go,%hello ,Java%,python","f1":" Go","f2":"hello ,Java"}
例3:
restrict=True,は、分割された値の数とターゲットフィールドが異なる場合、関数は実行されないことを示します。元のログ:
{"content": "1,2,3"}
加工ルール:
ext_sep("content", "f1, f2", restrict=True)
加工結果:
{"content":"1,2,3"}
ext_sepstr() 関数
関数定義
指定された文字(複数文字)に基づいてフィールド値の内容を抽出します。
構文記述
ext_sepstr("ソースフィールド名","ターゲットフィールド1,ターゲットフィールド2,ターゲットフィールド...", sep="abc", restrict=False, mode="overwrite")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | ユーザーログに既に存在するフィールド名 |
output | 単一のフィールド名、または英語の半角カンマで連結された複数の新しいフィールド名 | string | はい | - | - |
sep | 区切り文字(列) 注意: 区切り文字に特殊文字(例: . \\ * + ? ^ $ | () [] {} - /)が含まれる場合は、エスケープ文字を追加する必要があります。 | string | いいえ | , | - |
restrict | デフォルトはFalseです。抽出された値の数がユーザーが入力した対象フィールド数と一致しない場合: True:無視し、いかなる抽出処理も行いません。 False:可能な限り先頭のいくつかのフィールドに一致させます。 | bool | いいえ | False | - |
mode | 新規フィールドの書き込みモードです。デフォルトでは強制上書きされます。 | string | いいえ | overwrite |
例
元のログ:
{"message":"1##2##3"}
加工ルール:
//「##」を区切り文字として使用し、キー値を抽出します。ext_sepstr("message", "f1,f2,f3,f4", sep="##")
加工結果:
//ターゲットフィールドの数が分割された値を超えた場合、超過したフィールドは""を返します。{"f1":"1","f2":"2","message":"1##2##3","f3":"3","f4":""}
ext_json() 関数
関数定義
JSONからフィールド値を抽出します。
構文記述
ext_json("ソースフィールド名",prefix="",suffix="",format="full",exclude_node="フラット化しないJSONノード")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | - |
prefix | 新しいフィールドのプレフィックス | string | いいえ | - | - |
suffix | 新しいフィールドのサフィックス | string | いいえ | - | - |
format | full:フィールド名の形式はフルパスです(親ノード parent + 区切り文字 sep + prefix + key 現在のノード + suffix) simple:非フルパス(prefix + key 現在のノード + suffix) | string | いいえ | simple | - |
sep | 区切り文字。ノード名の連結に使用します。 | string | いいえ | # | - |
depth | 最大展開階層の深さです。この階層を超えたノードは展開されません。 | number | いいえ | 100 | 1-500 |
expand_array | 配列ノードを展開するかどうか | bool | いいえ | False | - |
include_node | 正規表現によるノード名一致に基づく許可リスト | string | いいえ | - | - |
exclude_node | 正規表現によるノード名一致に基づく拒否リスト | string | いいえ | - | - |
include_path | 正規表現によるノードパス一致に基づく許可リスト | string | いいえ | - | - |
exclude_path | 正規表現によるノードパス一致に基づく拒否リスト | string | いいえ | - | - |
retain | 一部の特殊文字はエスケープせずに保持します。例えば:\\n、\\t | string | いいえ | - | - |
escape | データをエスケープする必要があるかどうかです。デフォルト値はTrueで、特殊文字がある場合はエスケープできません。 | bool | いいえ | True | - |
例
例1:全ノードのKVを抽出して新規フィールドとします。抽出時に階層を区別しません。この例は多層ネストです。
元のログ:
{"data": "{ \\"k1\\": 100, \\"k2\\": { \\"k3\\": 200, \\"k4\\": { \\"k5\\": 300}}}"}
加工ルール:
ext_json("data")
加工結果:
{"data":"{ \\"k1\\": 100, \\"k2\\": { \\"k3\\": 200, \\"k4\\": { \\"k5\\": 300}}}","k1":"100","k3":"200","k5":"300"}
例2:sub_field1は抽出に関与しません。
元のログ:
{"content": "{\\"sub_field1\\":1,\\"sub_field2\\":\\"2\\"}"}
加工ルール:
//exclude_node=subfield1は、このノードを抽出しないことを意味します。ext_json("content", format="full", exclude_node="sub_field1")
加工結果:
{"sub_field2":"2","content":"{\\"sub_field1\\":1,\\"sub_field2\\":\\"2\\"}"}
例3:子ノードにプレフィックスprefixを追加します。
元のログ:
{"content": "{\\"sub_field1\\":{\\"sub_sub_field3\\":1},\\"sub_field2\\":\\"2\\"}"}
加工ルール1:
//sub_field2が抽出される際、自動的にプレフィックスudf\\_が付与され、udf\\_\\_sub\\_field2になります。ext_json("content", prefix="udf_", format="simple")
加工結果1:
{"content":"{\\"sub_field1\\":{\\"sub_sub_field3\\":1},\\"sub_field2\\":\\"2\\"}","udf_sub_field2":"2","udf_sub_sub_field3":"1"}
加工ルール2:
//format=fullは、抽出されるフィールド名に階層関係が含まれることを示します。sub_field2が抽出される際、自動的にその親ノード名が付与され、#content#__sub_field2になります。ext_json("content", prefix="__", format="full")
加工結果2:
{"#content#__sub_field2":"2","#content#sub_field1#__sub_sub_field3":"1","content":"{\\"sub_field1\\":{\\"sub_sub_field3\\":1},\\"sub_field2\\":\\"2\\"}"}
例4:特殊文字をサポートします。
元のログ1:
{"content": "{\\"sub_field1\\":1,\\"sub_field2\\":\\"\\\\n2\\"}"}
加工ルール1:
ext_json("content",retain="\\n")
加工結果1:
{"sub_field2":"\\\\n2","content":"{\\"sub_field1\\":1,\\"sub_field2\\":\\"\\\\n2\\"}","sub_field1":"1"}
元のログ2:
{"content": "{\\"sub_field1\\":1,\\"sub_field2\\":\\"\\\\n2\\\\t\\"}"}
加工ルール2:
ext_json("content",retain="\\n,\\t")
加工結果2:
{"sub_field2":"\\\\n2\\\\t","content":"{\\"sub_field1\\":1,\\"sub_field2\\":\\"\\\\n2\\\\t\\"}","sub_field1":"1"}
例5:エスケープ処理をカスタマイズします。
元のログ:
{"message":"{\\"ip\\":\\"183.6.104.157\\",\\"params\\":\\"[{\\\\\\"tokenType\\\\\\":\\\\\\"RESERVED30\\\\\\",\\\\\\"otherTokenInfo\\\\\\":{\\\\\\"unionId\\\\\\":\\\\\\"123\\\\\\"},\\\\\\"unionId\\\\\\":\\\\\\"adv\\\\\\"}]\\"}"}
加工ルール:
ext_json("message", escape=False)fields_drop("message")
加工結果:
{"ip":"183.6.104.157", "params":"[{\\"tokenType\\":\\"RESERVED30\\",\\"otherTokenInfo\\":{\\"unionId\\":\\"123\\"},\\"unionId\\":\\"adv\\"}]"}
ext_json_jmes() 関数
関数定義
JSONからフィールド値を抽出します。
構文記述
ext_json_jmes("ソースフィールド名", jmes= "JSON抽出式", output="ターゲットフィールド", ignore_null=True, mode="overwrite")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | - |
jmes | 説明: jmesに特殊文字(例: . \\ * + ? ^ $ | () [] {} - /)が含まれる場合は、エスケープ文字を追加する必要があります。 | string | はい | - | - |
output | 出力フィールド名。単一フィールドのみサポートされます。 | string | はい | - | - |
ignore_null | ノード値がnullのノードを無視するかどうかです。デフォルトはTrueで、nullフィールド値を無視します。それ以外の場合、抽出結果がnullのときは空文字列を出力します。 | bool | いいえ | True | - |
mode | 新規フィールドの書き込みモードです。デフォルトでは強制上書きされます。 | string | いいえ | overwrite |
例
例1:ノード値(リーフノード)を抽出します。
元のログ:
{"content": "{\\"a\\":{\\"b\\":{\\"c\\":{\\"d\\":\\"value\\"}}}}"}
加工ルール:
//jmes="a.b.c.d"は、a.b.c.dの値を取得することを意味します。ext_json_jmes("content", jmes="a.b.c.d", output="target")
加工結果:
{"content":"{\\"a\\":{\\"b\\":{\\"c\\":{\\"d\\":\\"value\\"}}}}","target":"value"}
例2:ノード値(非リーフノード)を抽出します。
元のログ:
{"content": "{\\"a\\":{\\"b\\":{\\"c\\":{\\"d\\":\\"value\\"}}}}"}
加工ルール:
//jmes="a.b.c.d"は、a.b.cの値を取得することを意味します。ext_json_jmes("content", jmes="a.b.c", output="target")
加工結果:
{"content":"{\\"a\\":{\\"b\\":{\\"c\\":{\\"d\\":\\"value\\"}}}}","target":"{\\"d\\":\\"value\\"}"}
ext_regex() 関数
関数定義
正規表現に基づいてフィールド値を抽出します。
構文記述
ext_regex("ソースフィールド名", regex="正規表現", output="ターゲットフィールド1、ターゲットフィールド2、ターゲットフィールド.......", mode="overwrite")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | - |
regex | regex式に特殊文字が含まれている場合、ユーザーは入力時にエスケープする必要があります。そうでない場合は構文エラーが表示されます。 | string | はい | - | - |
output | 単一のフィールド名、または英語の半角カンマで連結された複数の新しいフィールド名 | string | いいえ | - | - |
mode | 新規フィールドの書き込みモードです。デフォルトでは強制上書きされます。 | string | いいえ | overwrite |
例
例1:数字のマッチング
元のログ:
{"content": "1234abcd5678"}
加工ルール:
ext_regex("content", regex="\\d+", output="target1,target2")
加工結果:
{"target2":"5678","content":"1234abcd5678","target1":"1234"}
例2:名前付きキャプチャがあり、一部のフィールド値が自動的に入力されます。
元のログ:
{"content": "1234abcd"}
加工ルール:
ext_regex("content", regex="(?<target1>\\d+)(.*)", output="target2")
加工結果:
{"target2":"abcd","content":"1234abcd","target1":"1234"}
ext_kv() 関数
関数定義
二段階の区切り文字に基づいてフィールド値を抽出します。
構文記述
ext_kv("ソースフィールド名", pair_sep=r"\\s", kv_sep="=", prefix="", suffix="", mode="fill-auto")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | - |
pair_sep | 一次区切り文字、複数のキーと値のペアを分割します。 | string | はい | - | - |
kv_sep | 二次区切り文字、キーと値を分割します。 | string | はい | - | - |
prefix | 新しいフィールドのプレフィックス | string | いいえ | - | - |
suffix | 新しいフィールドのサフィックス | string | いいえ | - | - |
mode | 新規フィールドの書き込みモードです。デフォルトでは強制上書きされます。 | string | いいえ | overwrite |
例
ログには2段階の区切り文字「|」と「=」があります。
元のログ:
{"content": "a=1|b=2|c=3"}
処理ルール:
ext_kv("content", pair_sep="|", kv_sep="=")
処理結果:
{"a":"1","b":"2","c":"3","content":"a=1|b=2|c=3"}
ext_first_notnull() 関数
関数定義
パラメータ内の最初の非nullかつ非空文字の結果値を返します。
構文記述
ext_first_notnull(値1, 値2, ...)
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
可変引数リスト | 計算に参加するパラメータまたは式 | string | はい | - | - |
例
元のログ:
{"data1": null, "data2": "", "data3": "first not null"}
加工ルール:
fields_set("result", ext_first_notnull(v("data1"), v("data2"), v("data3")))
加工結果:
{"result":"first not null","data3":"first not null","data2":"","data1":"null"}
ext_grok 関数
関数定義
注意:
ログに . \\ * + ? ^ $ | () [] {} - / などの特殊文字が含まれる場合、grok構文ではエスケープを追加する必要があります。例えば、2024 Nov 9 -trumpの場合、対応するgrok式は%{YEAR:year} %{MONTH:month} %{MONTHDAY:day} \\-%{WORD:trump}で、抽出結果は{ "year": 2024, "month": "Nov", "day": 9,"President": "trump"}です。
構文記述
ext_grok(フィールド, grok="", extend="")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | フィールド | string | はい | - | - |
grok | 式 | string | はい | - | - |
extend | ユーザー定義のGROK式 | string | いいえ | - | - |
例
例1:デフォルトのPatternを使用して、日付と引用符内の文字列を抽出します。
元のログ:
{"content":"2019 June 24 \\"I am iron man\\""}
加工ルール:
ext_grok("content", grok="%{YEAR:year} %{MONTH:month} %{MONTHDAY:day} %{QUOTEDSTRING:motto}")fields_drop("content")
加工結果:
{"day":"24", "month":"June", "motto":"I am iron man", "year":"2019"}
例2:カスタムPatternを使用してキーバリューペアを抽出します。
元のログ:
{"content":"Beijing-1104,Beijing-Beijing"}
加工ルール:
//extend パラメータの役割は、カスタムパターンを定義することです。ID1=%{WORD}-%{INT}は、ID1パターンが1つの単語、1つのハイフン、1つの整数で構成されることを示します。ID2=%{WORD}-%{WORD}は、ID2パターンが1つの単語、1つのハイフン、もう1つの単語で構成されることを示します。ext_grok("content", grok="%{ID1:user_id1},%{ID2:user_id2}",extend="ID1=%{WORD}-%{INT},ID2=%{WORD}-%{WORD}")fields_drop("content")
加工結果:
{"user_id1":"Beijing-1104", "user_id2":"Beijing-Beijing"}
Grok リファレンス
タイプ | パターン | 説明 |
一般的なパターン | EXTRACTJSON | JSONタイプのデータをマッチングします。 |
| CHINAID | 中国居民身分証番号をマッチングします。 |
| USERNAME | 文字、数字、および._-の組み合わせをマッチングします。 |
| USER | 文字、数字、および._-の組み合わせをマッチングします。 |
| EMAILLOCALPART | メールアドレスの先頭から@文字の前までの内容をマッチングします。例えば、123@abc.comの場合、マッチング内容は123です。 |
| EMAILADDRESS | メールアドレスをマッチングします。 |
| HTTPDUSER | メールアドレスまたはユーザー名をマッチングします。 |
| INT | INT数字をマッチングします。 |
| BASE10NUM | 十進数をマッチングします。 |
| NUMBER | 数字をマッチングします。 |
| BASE16NUM | 十六進数をマッチングします。 |
| BASE16FLOAT | 十六進浮動小数点数をマッチングします。 |
| POSINT | 正の整数をマッチングします。 |
| NONNEGINT | 非負整数をマッチングします。 |
| WORD | 文字、数字、下線をマッチングします。 |
| NOTSPACE | 非スペース文字列をマッチングします。 |
| SPACE | スペースをマッチングします。 |
| DATA | 改行文字をマッチングします。 |
| GREEDYDATA | 0個以上の改行文字をマッチングします。 |
| QUOTEDSTRING | 引用内容をマッチングします。例えば、I am "Iron Man"の場合、「Iron Man」にマッチングします。 |
| UUID | UUIDをマッチングします。 |
Networking | MAC | MACアドレスをマッチングします。 |
| CISCOMAC | CISCOMACアドレスをマッチングします。 |
| WINDOWSMAC | WINDOWSMACアドレスをマッチングします。 |
| COMMONMAC | COMMONMACアドレスをマッチングします。 |
| IPV6 | IPV6をマッチングします。 |
| IPV4 | IPV4をマッチングします。 |
| IP | IPV6またはIPV4をマッチングします。 |
| HOSTNAME | HOSTNAMEをマッチングします。 |
| IPORHOST | IPまたはHOSTNAMEをマッチングします。 |
| HOSTPORT | IPORHOSTまたはPOSTINTをマッチングします。 |
Paths | PATH | UNIXPATHまたはWINPATHをマッチングします。 |
| UNIXPATH | UNIXPATHをマッチングします。 |
| WINPATH | WINPATHをマッチングします。 |
| URIPROTO | URIの先頭部分をマッチングします。例えば、http://hostname.domain.tld/_astats?application=&inf.name=eth0はhttpにマッチングします。 |
| TTY | TTYパスをマッチングします。 |
| URIHOST | IPORHOSTとPOSINTをマッチングします。例えば、http://hostname.domain.tld/_astats?application=&inf.name=eth0はhostname.domain.tldにマッチングします。 |
| URI | コンテンツ内のURIをマッチングします。 |
日付 | MONTH | 数字、月の英語略称、または正式名称などの形式の月をマッチングします。 |
| MONTHNUM | 数字形式の月をマッチングします。 |
| MONTHDAY | 月の日にちをマッチングします。 |
| DAY | 曜日の英語の正式名称または略称をマッチングします。 |
| YEAR | 年をマッチングします。 |
時間 | HOUR | 時間をマッチングします。 |
| MINUTE | 分をマッチングします。 |
| SECOND | 秒をマッチングします。 |
| TIME | 完全な時刻をマッチングします。 |
| DATE_US | Month-Day-YearまたはMonth/Day/Year形式の日付をマッチングします。 |
| DATE_EU | Day-Month-Year、Day/Month/Year、またはDay.Month.Year形式の日付をマッチングします。 |
| ISO8601_TIMEZONE | ISO8601形式の時間と分をマッチングします。 |
| ISO8601_SECOND | ISO8601形式の秒をマッチングします。 |
| TIMESTAMP_ISO8601 | ISO8601形式の時刻をマッチングします。 |
| DATE | USまたはEU形式の日付をマッチングします。 |
| DATESTAMP | 完全な日付と時刻をマッチングします。 |
| TZ | UTCをマッチングします。 |
| DATESTAMP_RFC822 | RFC822形式の時刻をマッチングします。 |
| DATESTAMP_RFC2822 | RFC2822形式の時刻をマッチングします。 |
| DATESTAMP_OTHER | その他の形式の時刻をマッチングします。 |
| DATESTAMP_EVENTLOG | EVENTLOG形式の時刻をマッチングします。 |
| HTTPDERROR_DATE | HTTPDERROR形式の時刻をマッチングします。 |
SYSLOG | SYSLOGTIMESTAMP | Syslog形式の時刻をマッチングします。 |
| PROG | program内容をマッチングします。 |
| SYSLOGPROG | programとpidの内容をマッチングします。 |
| SYSLOGHOST | IPORHOSTをマッチングします。 |
| SYSLOGFACILITY | facilityをマッチングします。 |
| HTTPDATE | 日付と時刻をマッチングします。 |
LOGFORMATL | LOGFORMAT | Syslogをマッチングします。デフォルトはTraditionalFormat形式のSyslogログです。 |
| COMMONAPACHELOG | commonApacheログをマッチングします。 |
| COMBINEDAPACHELOG | 組み合わせApacheログをマッチングします。 |
| HTTPD20_ERRORLOG | HTTPD20ログをマッチングします。 |
| HTTPD24_ERRORLOG | HTTPD24ログをマッチングします。 |
| HTTPD_ERRORLOG | HTTPDログをマッチングします。 |
LOGLEVEL | LOGLEVEL | LogのLevelをマッチングします。例えば、warn、debug、infoなどです。 |
フィードバック