行処理関数
ダウンロード
フォーカスモード
フォントサイズ
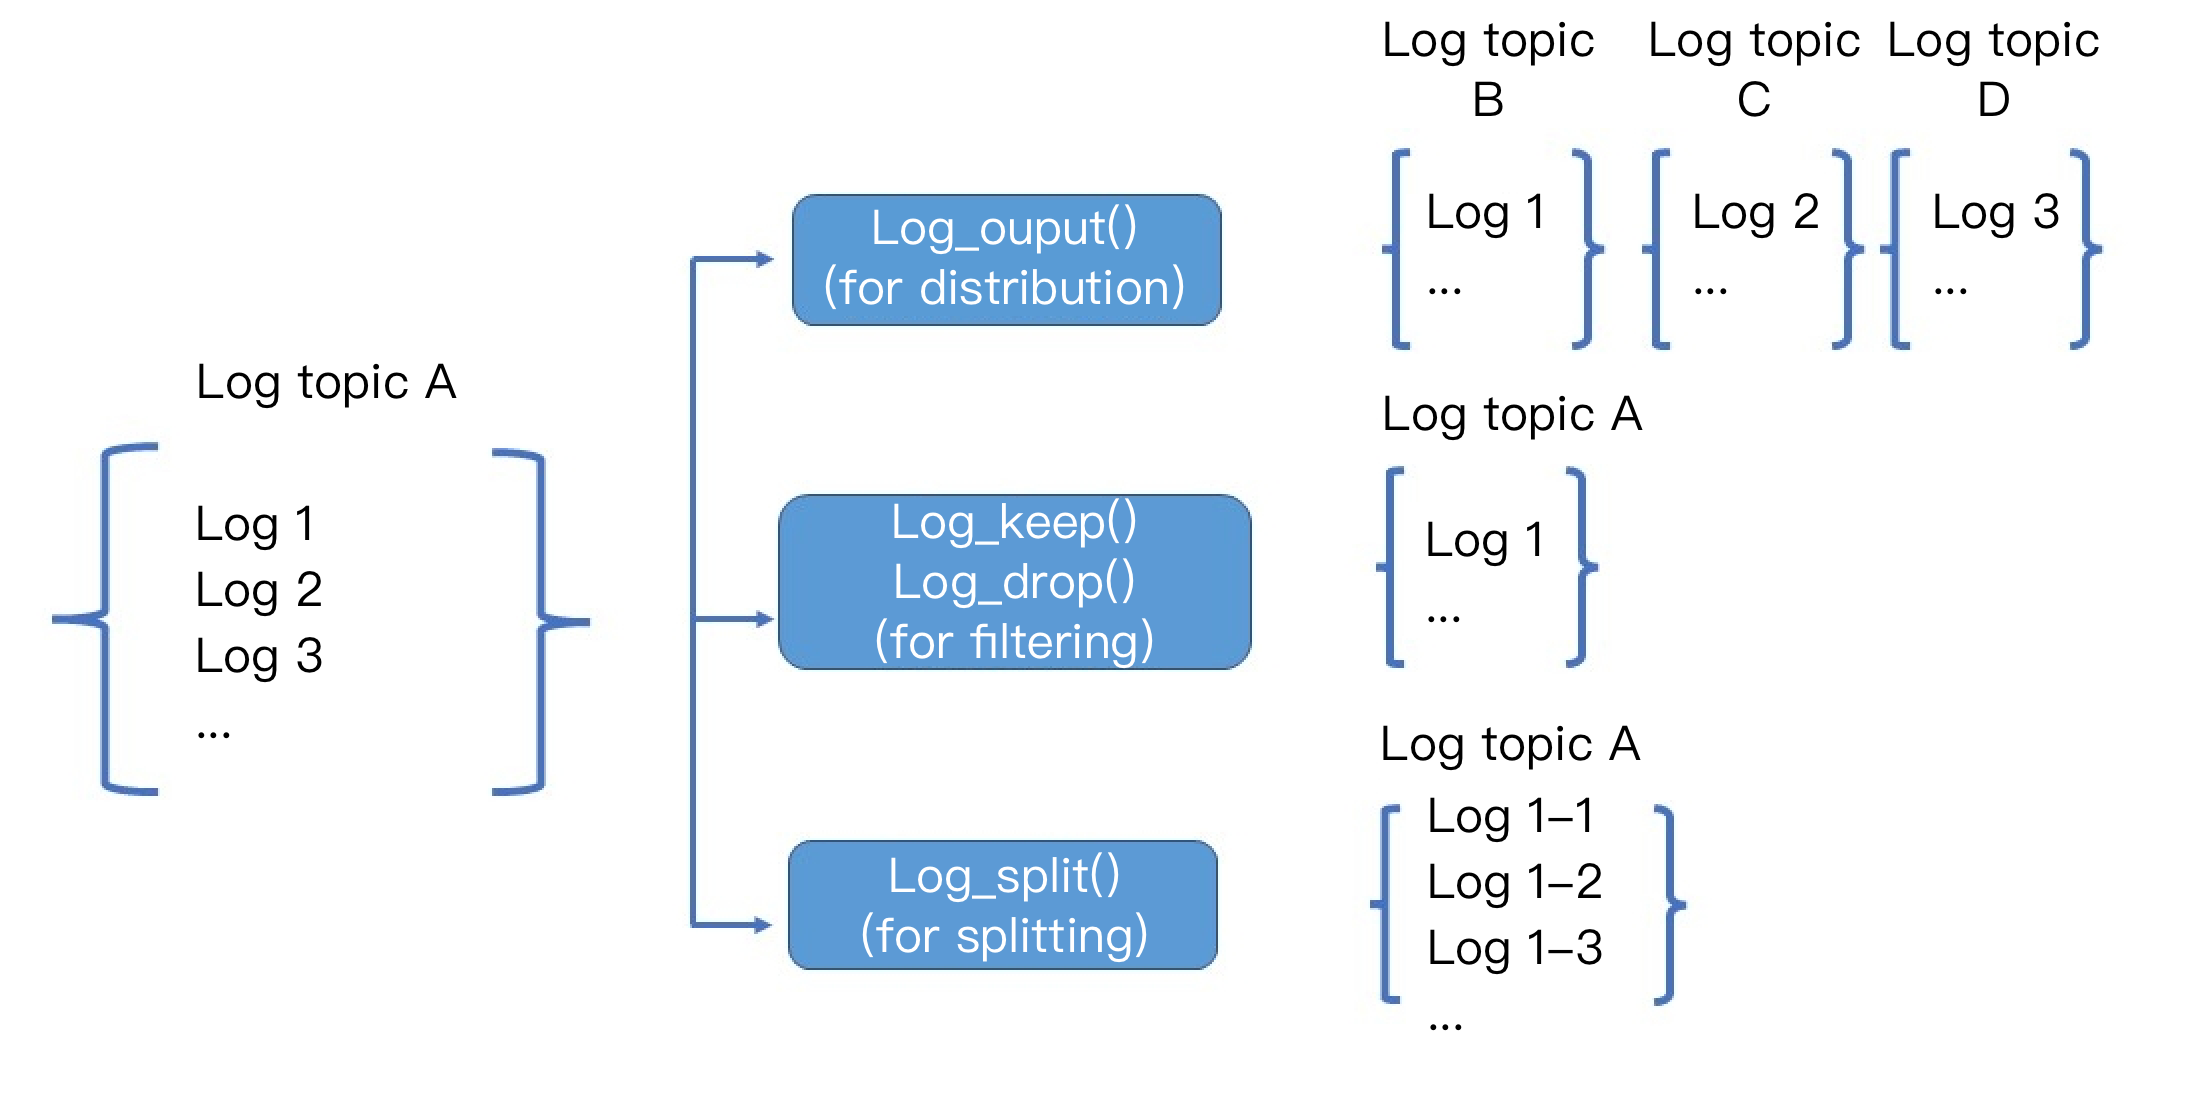
1行のログに対して、フィルタリング、振り分け、分割などの関数で処理を行います。
log_output関数
関数定義
指定されたターゲットトピックに出力します。分岐条件と組み合わせて使用することも、単独で使用することもできます。
構文記述
log_output(エイリアス Alias)
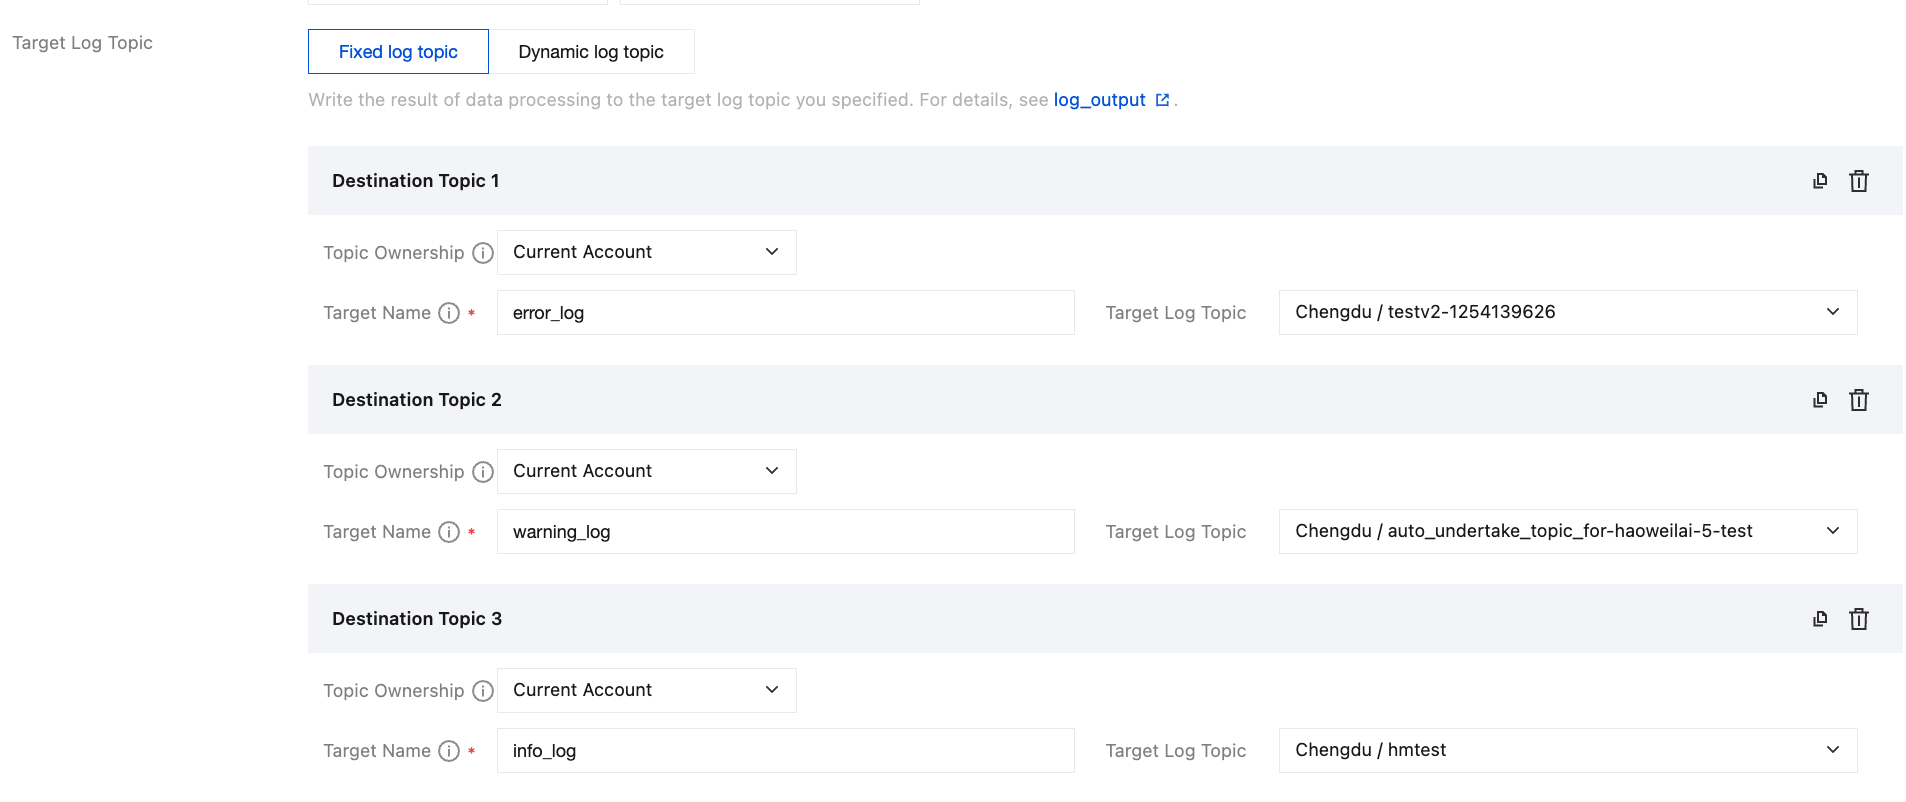
エイリアスはデータ加工タスクの設定時に定義されます。下図に示すとおりです:
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
alias | ターゲットトピックのエイリアス | string | はい | - | - |
例
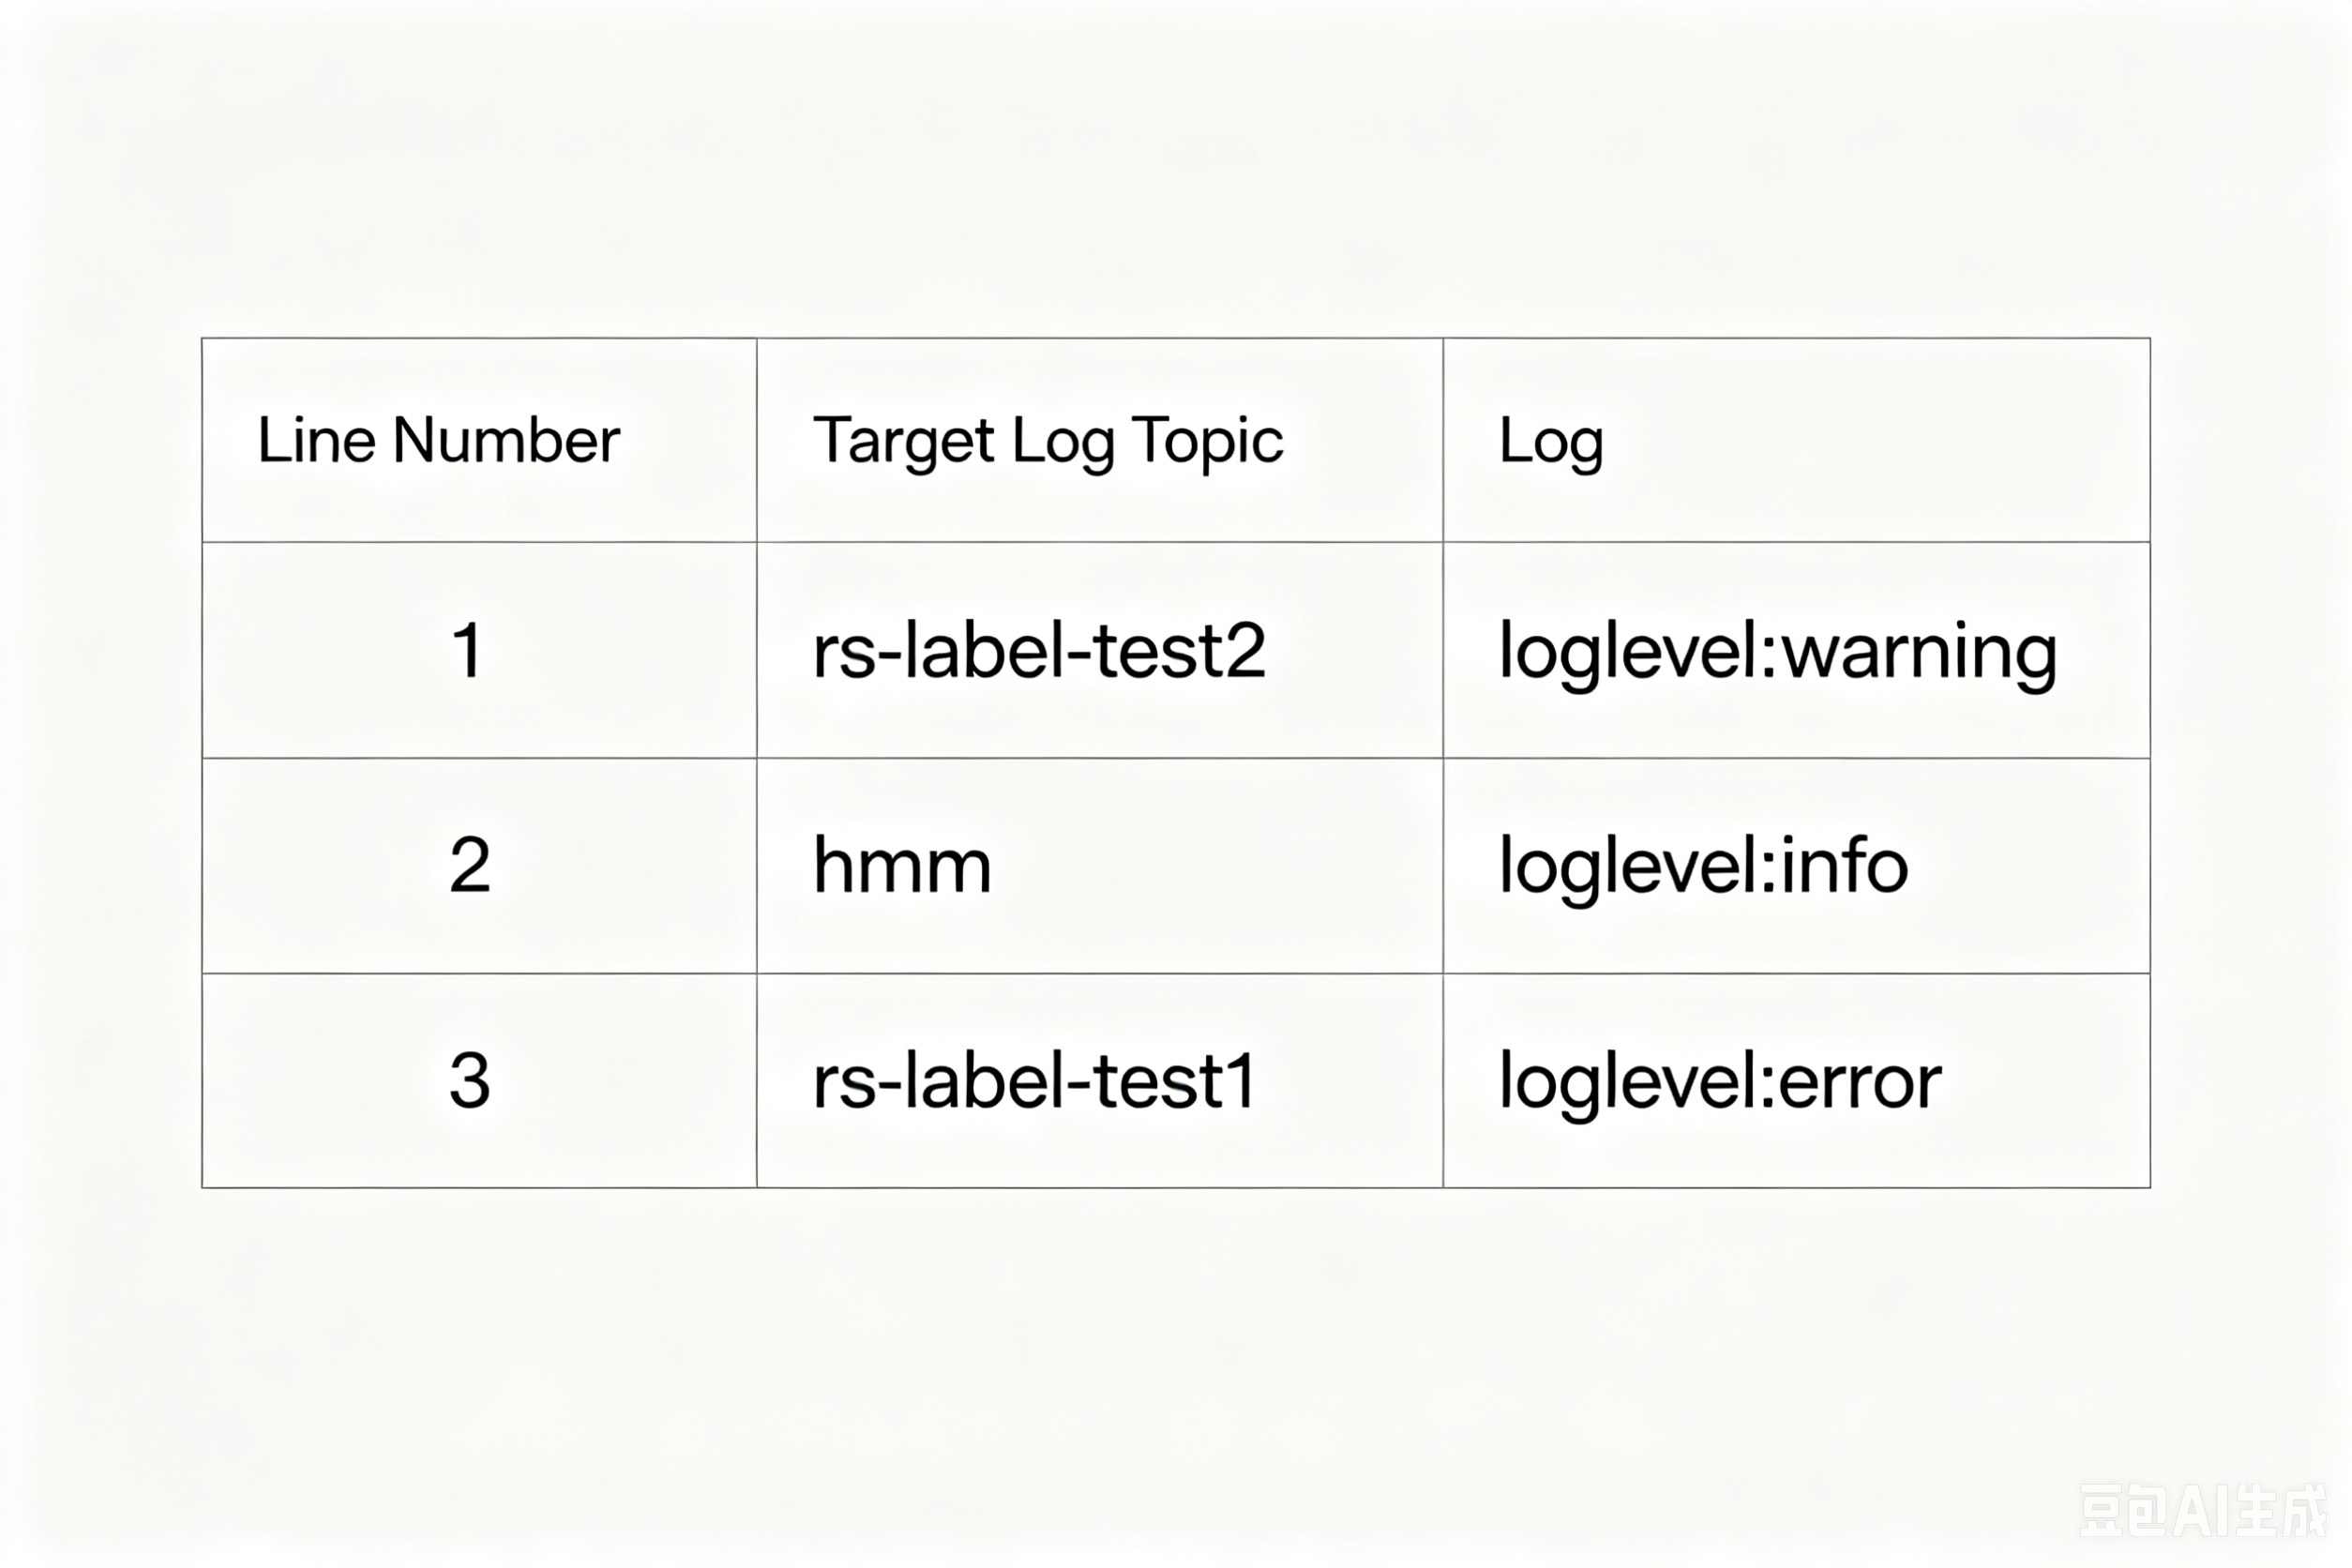
loglevelフィールドの値がwarning/info/errorの場合に応じて、3つの異なるログトピックに振り分けます。
元のログ:
[{"loglevel": "warning"},{"loglevel": "info"},{"loglevel": "error"}]
加工ルール:
//loglevelフィールドの値がwarning/info/errorの場合に応じて、3つの異なるログトピックに振り分けます。t_switch(regex_match(v("loglevel"),regex="info"),log_output("info_log"),regex_match(v("loglevel"),regex="warning"),log_output("warning_log"),regex_match(v("loglevel"),regex="error"),log_output("error_log"))
加工結果は下図のとおりです:
log_auto_output関数
関数定義
ログを動的なターゲットトピックに出力します。例えば、ログフィールド「pd」の値に基づいて、複数のターゲットログトピックを動的に作成し、対応するログをターゲットログトピックに振り分ける必要があります。pdの値が「CLB 」、「Ckafka」、「COS」、「CDN」であると仮定します。この関数を使用すると、「CLB 」、「Ckafka」、「COS」、「CDN」という名前のターゲットログトピックが動的に作成され、関連するログが対応するトピックに書き込まれます。同時に、これらの新規トピックのインデックスタイプと保存期間を設定できます。
構文記述
log_auto_output(topic_name="", logset_name="", index_options="", period=3,storage_type=" ",hot_period=0)
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータ デフォルト値 | パラメータ説明 |
topic_name | 動的に生成されたログトピック名。 例えば v("loglevel")の場合、タスクは「Error」、「Info」、「Warning」という名前の3つのログトピックを自動的に生成します。 (お客様のログにおいて、loglevelフィールドが上記3つの値であると仮定します) | string | y | - | パラメータtopic_nameに「|」が含まれている場合、「|」は生成されるトピック名から削除されます。 パラメータtopic_nameの長さが250文字を超える場合、生成されるログトピック名は先頭の250文字のみとなり、超過分は切り捨てられます。 |
logset_name | 動的に生成されたログトピック名。 例えば「my_logSet」の場合、タスクは名前が「my_logSet」のログセットを自動的に作成します。 例えばv("namespace")の場合、タスクは名前が「dev」、「test」の2つのログセットを自動的に作成します。(ログ内のnamespaceフィールドが上記2つの値であると仮定します。) | string | y | - | - |
index_options | all_index:キー値インデックスと全文インデックスを有効にします。 no_index:インデックスを有効にしません。 content_index:全文インデックスを有効にします。 key_index:キー値インデックスを有効にします。 | string | n | all_index | storage_type=cold、つまり低頻度ストレージの場合、all_indexとkey_indexは有効になりません。つまり、低頻度ストレージはキー値インデックスをサポートしません。 |
period | 保存期間。一般的な値の範囲は1~3600日です。 3640は永久保存を表します。 | number | n | 3 | 1~3600日です。 |
storage_type | ログトピックのストレージタイプ。選択可能な値です。 hot:標準ストレージ cold:低頻度ストレージ | string | n | hot | coldの場合、periodは最小7日です。 |
hot_period | 0:ログ沉降を無効にします。 0以外:ログ沉降を有効にした後、標準ストレージに保存される日数 HotPeriodは7以上、かつPeriod未満である必要があります。StorageTypeがhotの場合にのみ有効になります。 | number | n | 0 | - |
tag_dynamic | ログトピックに動的タグを追加し、extract_tag()関数と連携して、ログフィールドからタグのKVを抽出するために使用します。例えば:tag_dynamic=extract_tag(v("pd"),v("env"),v("team"), v("person")) | string | n | - | tag_staticと合わせて10ペアのタグを超えないこと。 |
tag_static | ログトピックに静的タグを追加します。例えば:tag_static="Ckafka:test_env,developer_team:MikeWang" | string | n | - | tag_dynamicと合わせて10ペアのタグを超えないことの例です。 |
注意:
log_auto_output()関数内のパラメータを変更してタスクを再起動した後、その変更は新しく生成されたトピックにのみ有効であり、既に生成されたトピックには影響しません。既に生成されたログセットまたはトピックの属性を調整する必要がある場合は、ログトピックリストに移動するか、APIを呼び出して変更してください。
データ加工タスク(動的にトピックを作成)を削除しても、作成済みのログセットとログトピックは削除されません。
パラメータtopic_nameの取得に失敗した場合、または「」(空文字列)の場合、この行のログは「null」という名前のログトピックに送信されます。「null」というトピック名を使用したくない場合は、
log_auto_output( str_join("-", "myPrefix", v("app")), "myLogSet")の構文を参照してください。appが存在しない場合、または値が「 」の場合、ログは「myprefix」という名前のログトピックに書き込まれます。ログセットとログトピックの名前は、英字の大文字と小文字を区別しません。abcとAbcはCLS側では同じリソースを表します。
例
元のログ:
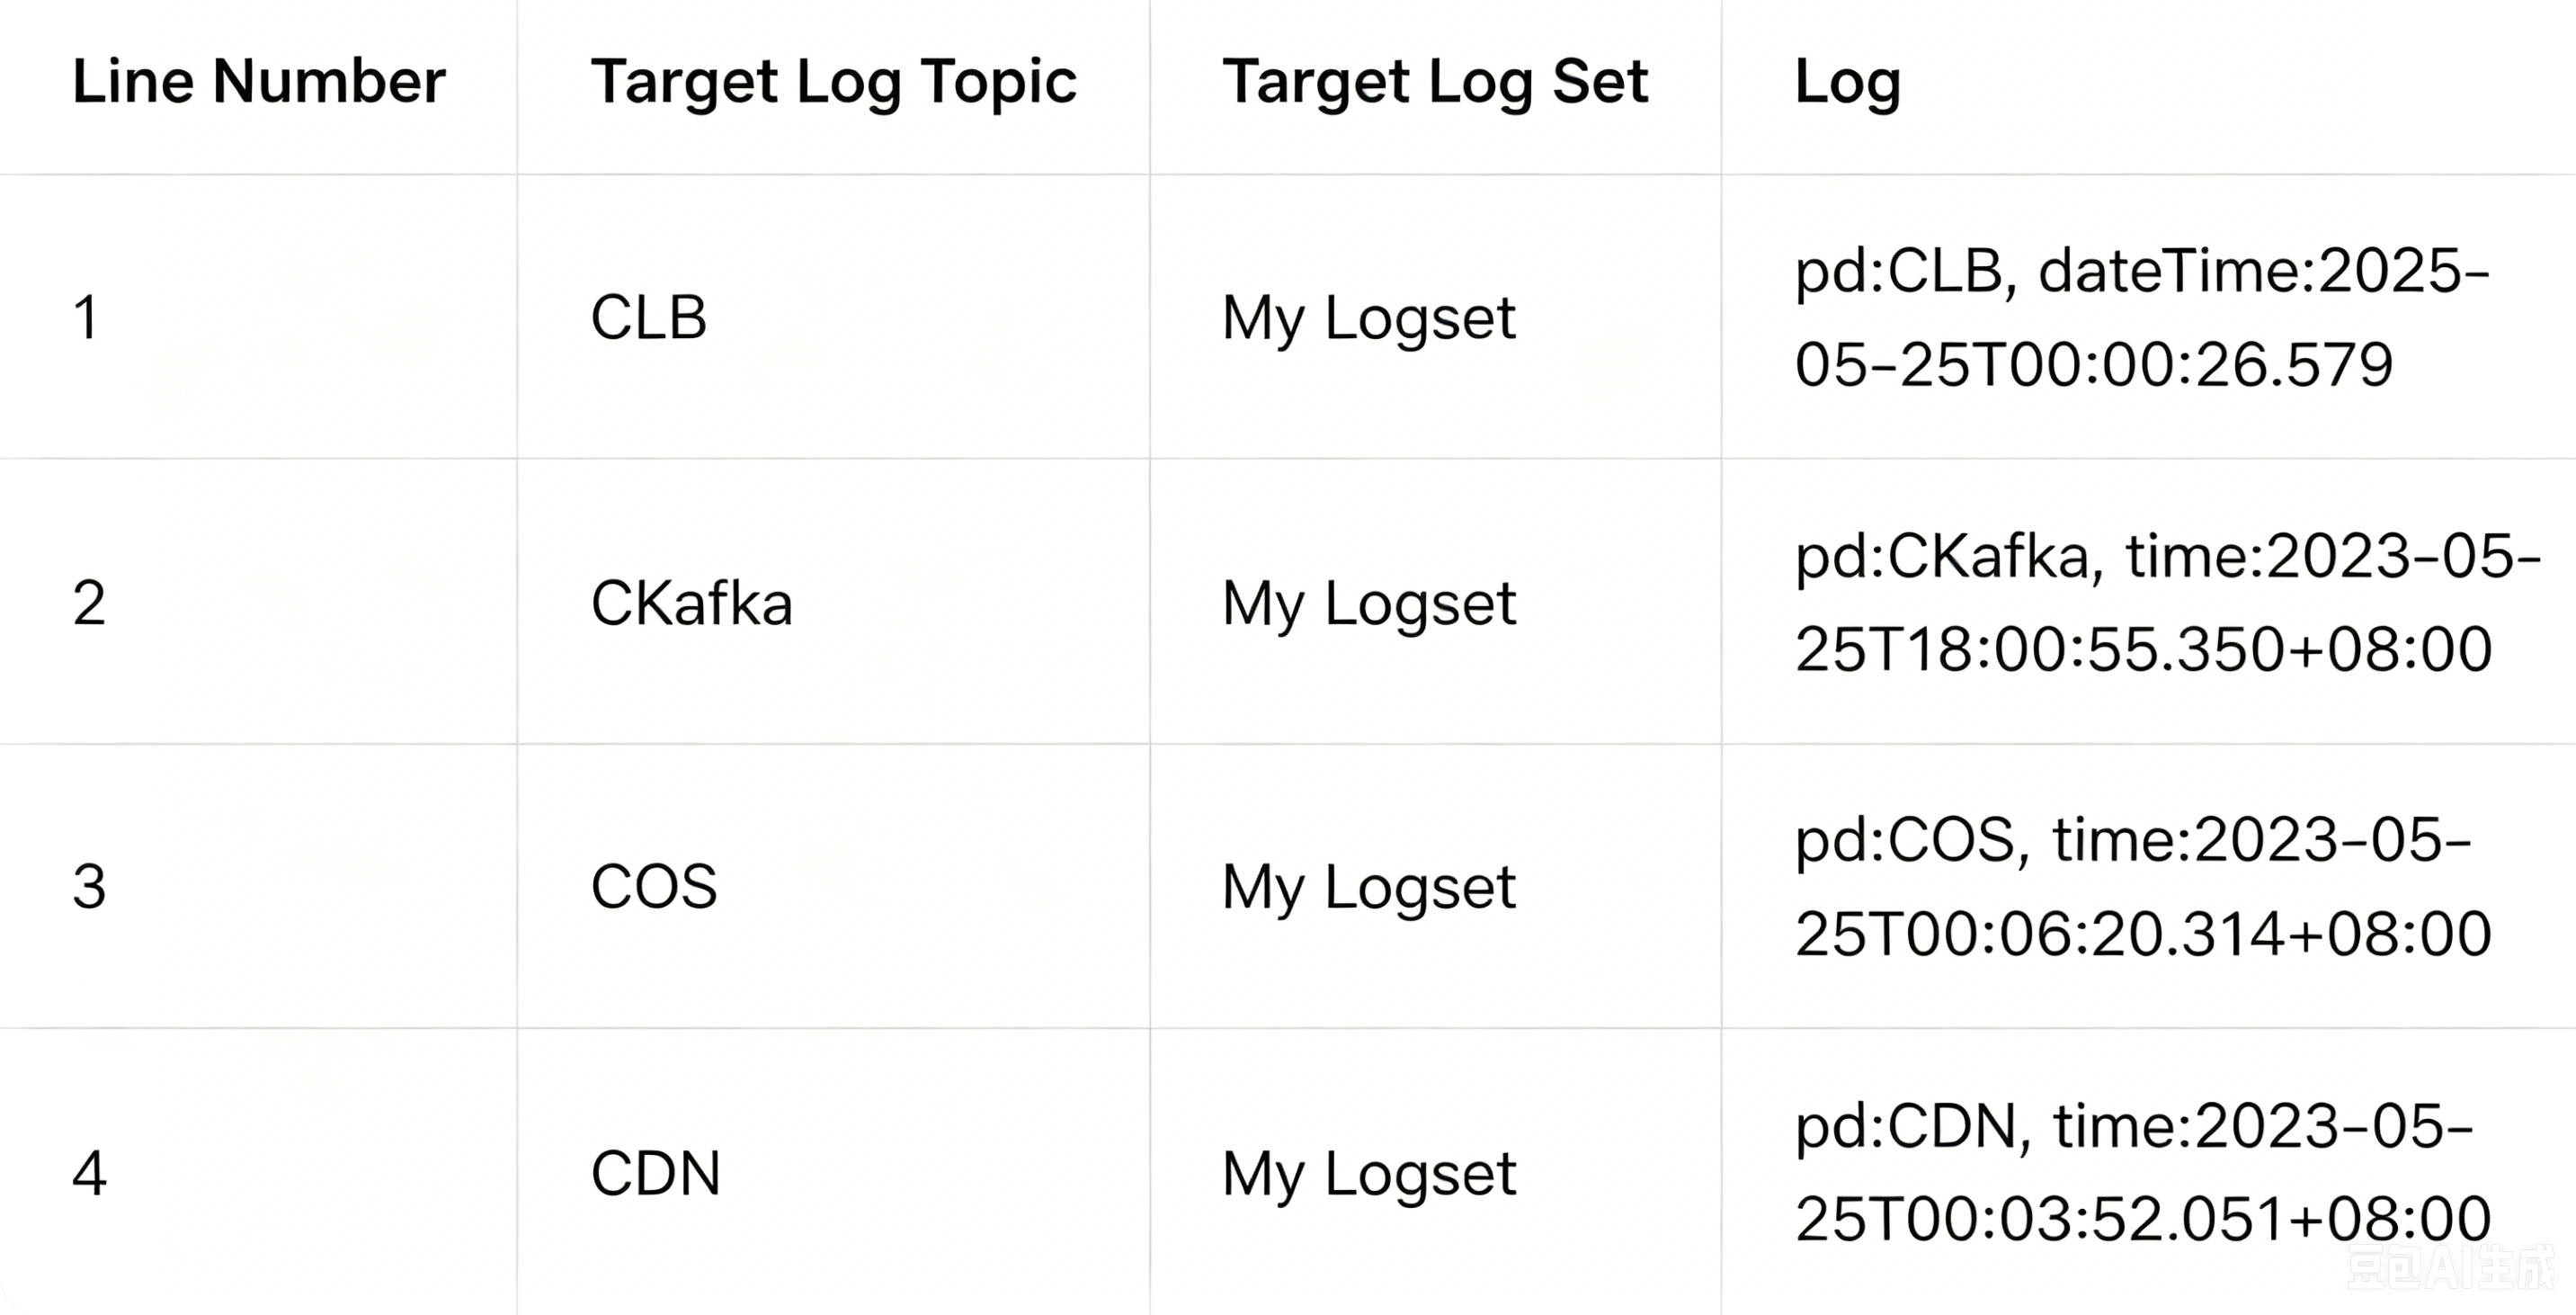
[{"pd": "CLB","dateTime": "2023-05-25T00:00:26.579"},{"pd": "Ckafka","time": "2023-05-25T18:00:55.350+08:00"},{"pd": "COS","time": "2023-05-25T00:06:20.314+08:00"},{"pd": "CDN","time": "2023-05-25T00:03:52.051+08:00"}]
加工ルール:
log_auto_output(v("pd"),"我的日志集",index_options="content_index", period=3)
加工結果:4つのログトピックが自動的に生成されました。それぞれ「CLB 」、「Ckafka」、「COS」、「CDN」です。ログセット名は「我的日志集」で、下図の通りです:
管理メカニズムの説明:
データ加工タスクにおける、動的に生成されるログセットとログトピックの管理メカニズム:カスタムIDバインディング。
データ加工タスク(log_auto_output関数の実行など)の実行時には、入力したログセット/ログトピック名、リージョン、AppIDに基づいて、MD5アルゴリズムを使用し、動的に生成されるログセット/ログトピックに対してカスタムIDを生成します。タスクがログセット/ログトピックを管理し、ログトピックにデータを書き込む際には、このカスタムIDのみを認識し、コンソールに表示されるログセット/ログトピック名は認識しません。
典型的なシナリオと例の説明
シナリオ1:コンソールで手動で名前を変更する(データ書き込みに影響なし)
タスクはカスタムIDによってリソースを管理しているため、コンソールで生成済みのログセットまたはトピック名を変更しても、その後のデータ書き込みには影響しません。
例:タスクがNginxというログトピックを動的に作成しました。コンソールでNginx001に名前を変更しました。
結果:データ加工タスクはNginxという新しいログトピックを再作成することはなく、基盤となるIDに基づいて、名前変更後のNginx001に正確にデータを書き込み続けます。
シナリオ2:コードパラメータを変更して再起動する(新規リソースにのみ有効)
加工スクリプト(コード)内の名前パラメータを直接変更した場合、カスタムIDの計算因子を変更したことになり、基盤はそれを全新規タスクとして扱います。
例:
1. 初期コード:log_auto_output("mytopic", "mylogset")-->タスクは「mylogset」ログセットを生成しました。
2. コンソールで手動で「myLogSet-1」に名前を変更しました。
3. その後、コードを変更してタスクを再起動します:log_auto_output("mytopic", "myLogSet-1")。
結果:タスクはコンソールでの名前変更操作を認識できません。コードパラメータが変更されたため、新しいIDが計算され、名前が「myLogSet-1-CreateByCLSETL」の新しいログセットが直接作成されます。名前変更後の「myLogSet-1」には書き込まれません。
シナリオ3:重複名の処理
動的に作成された名前が既存のログトピック/ログセットと重複する場合、システムの処理ロジックは以下の通りです:
名前が重複するシナリオ | 処理ルール | 実際の結果例 |
ログセット/ログトピック test を手動で作成し、タスクでも test を作成する必要があります。 | -CreateByCLSETL サフィックスを自動的に追加して隔離します。 | タスクは実際に test-CreateByCLSETL という名前のログセット/ログトピックを作成しました。 |
加工タスク1とタスク2の両方で、ログセットを myLogSet として定義しています。 | 計算されたカスタムIDが同じであれば、後続のタスクは既存のリソースを再利用し、サフィックスを追加しません。 | タスク2は当該ログセットを直接共用し、重複して作成することはありません。 |
ログトピックへのタグ追加
特殊なシナリオ | 処理ロジック |
動的タグのKV値の取得に失敗しました | 例えば、Aフィールドの値をタグのKeyに、Bフィールドの値をタグのValueに指定した場合、ある行のログにAフィールドまたはBフィールドがない場合、またはAフィールドとBフィールドの値が空の場合、タグの追加に失敗します。 |
タグのKV値の前後にスペースがあります | タグの追加に失敗しました。 |
動的タグと静的タグの合計数が10ペアを超えている | 動的タグの優先度が高く、動的タグを追加した後も10ペアに満たない場合は静的タグを補充しますが、合計数は10ペアを超えません。 |
タグKVの長さが制限を超えています | タグのkeyの長さが127を超えるか、valueの長さが255を超える場合、タグの追加に失敗します。 |
説明:
POCで同名の加工タスクを繰り返し再作成する必要がある場合、その手順は以下の通りです:
1. 先に古いデータ加工タスクを削除してください。そうしないと、ログトピックが継続的に生成されます。
2. フォールバックトピック auto_undertake_topic_${etl-task-name} を削除してください。同名タスクを連続3回作成した場合、上限超過のフォールバックトピックは作成に失敗し、タスクの正常な起動がブロックされます。
POCのデータが同一セットであり、リアルタイムデータではない場合は、古いタスクがすでに生成したログセットとログトピックを削除することをお勧めします。
log_split関数
関数定義
区切り文字とjmes式を組み合わせて特定のフィールドを分割し、分割結果は複数行のログに展開されます。
構文記述
log_split(filed, sep=",", quote="\\", jmes="", output="")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | - |
sep | 区切り文字 | string | いいえ | , | 任意の1文字 |
quote | 値を囲む文字 | string | いいえ | - | - |
jmes | 説明: jmesに特殊文字(例: . \\ * + ? ^ $ | () [] {} - /)が含まれる場合は、エスケープ文字を付ける必要があります。 | string | いいえ | - | - |
output | 単一フィールド名 | string | はい | - | - |
例
例1:フィールドに複数の値があるログの分割
{"field": "hello Go,hello Java,hello python","status":"500"}
加工ルール:
//区切り文字「、」を使用して、ログを3つに分割します。log_split("field", sep=",", output="new_field")
加工結果:
{"new_field":"hello Go","status":"500"}{"new_field":"hello Java","status":"500"}{"new_field":"hello python","status":"500"}
例2:JMESを使用してログを分割します。
{"field": "{\\"a\\":{\\"b\\":{\\"c\\":{\\"d\\":\\"a,b,c\\"}}}}", "status": "500"}
加工ルール:
//a.b.c.dノードの値は「a,b,c」です。log_split("field", jmes="a.b.c.d", output="new_field")
加工結果:
{"new_field":"a","status":"500"}{"new_field":"b","status":"500"}{"new_field":"c","status":"500"}
例3:JSON配列を含むログの分割。
{"field": "{\\"a\\":{\\"b\\":{\\"c\\":{\\"d\\":[\\"a\\",\\"b\\",\\"c\\"]}}}}", "status": "500"}
加工ルール:
log_split("field", jmes="a.b.c.d", output="new_field")
加工結果:
{"new_field":"a","status":"500"}{"new_field":"b","status":"500"}{"new_field":"c","status":"500"}
log_drop関数
関数定義
条件を満たすログを破棄します。
構文記述
log_drop(条件1)
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
condition | bool型の関数式 | bool | はい | - | - |
例
status=200のログを破棄し、それ以外は保持します。
元のログ:
[{"field": "a,b,c","status": "500"},{"field": "a,b,c","status": "200"}]
加工ルール:
log_drop(op_eq(v("status"), 200))
加工結果:
{"field":"a,b,c","status":"500"}
log_keep関数
関数定義
条件を満たすログを保持します。
構文記述
log_keep(条件1)
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
condition | bool型の関数式 | bool | はい | - | - |
例
status=500のログを保持し、それ以外は破棄します。
元のログ:
[{"field": "a,b,c","status": "500"},{"field": "a,b,c","status": "200"}]
加工ルール:
log_keep(op_eq(v("status"), 500))
加工結果:
{"field":"a,b,c","status":"500"}
log_split_jsonarray_jmes関数
関数定義
ログをJmes構文に基づいてJSON配列を分割および展開します。
構文記述
log_split_jsonarray_jmes("field", jmes="items", prefix="")
パラメータ説明
パラメータ名 | パラメータ説明 | パラメータタイプ | 必須かどうか | パラメータのデフォルト値 | パラメータの値の範囲 |
field | 抽出対象のフィールド名 | string | はい | - | - |
例
例1
元のログ:
{"common":"common","result":"{\\"target\\":[{\\"a\\":\\"a\\"},{\\"b\\":\\"b\\"}]}"}
加工ルール:
log_split_jsonarray_jmes("result",jmes="target")fields_drop("result")
加工結果:
{"common":"common", "a":"a"}{"common":"common", "b":"b"}
例2
元のログ:
{"common":"common","target":"[{\\"a\\":\\"a\\"},{\\"b\\":\\"b\\"}]"}
加工ルール:
log_split_jsonarray_jmes("target",prefix="prefix_")fields_drop("target")
加工結果:
{"prefix_a":"a", "common":"common"}{"prefix_b":"b", "common":"common"}
フィードバック