Funcionalidades do TencentOS Server
Baixar
Modo Foco
Tamanho da Fonte
No cenário nativo da nuvem, Namespace e Cgroup fornecem suporte básico para isolar recursos, mas a capacidade global de isolamento de contêineres ainda é incompleta. Especialmente, algumas informações estatísticas de recursos nos sistemas de arquivos /proc e /sys não são contêinadas, fazendo com que alguns comandos comuns executados dentro de contêiner (como free, top) não mostrem com precisão o uso de recursos do contêiner.
Para resolver este problema, o kernel de TencentOS lançou a solução cgroupfs, que visa melhorar a apresentação de recursos de contêineres. O cgroupfs implementa um sistema de arquivos virtual que inclui arquivos como /proc e /sys, necessários para o negócio da perspectiva de contêineres. Sua estrutura de diretórios mantém consistência com os procfs globais e sysfs, para garantir a compatibilidade com as ferramentas do usuário. Quando esses arquivos são realmente lidos, o cgroupfs gera dinamicamente a visão correspondente da informação do contêiner por contexto do processo leitor.
Monte e carregue o sistema de arquivos cgroupfs
1. Execute o seguinte comando para montar e carregar o sistema de arquivos cgroupfs.
mount -t cgroupfs cgroupfs /cgroupfs/
A tela de captura é a seguinte:
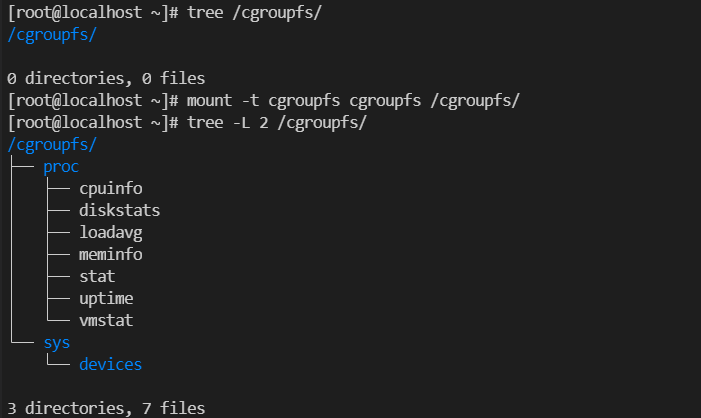
2. Use a opção '-v ' para montar e carregar os arquivos sob 'cgroupfs' depende demanda para um contêiner indicado. O comando de inicialização para o docker é o seguinte:
docker run -itd --cpus 2 --cpuset-cpus 0,1,2,4 -v/cgroupfs/sys/devices/system/cpu/:/sys/devices/system/cpu -v/cgroupfs/proc/cpuinfo:/proc/cpuinfo -v/cgroupfs/proc/stat:/proc/stat -v/cgroupfs/proc/meminfo:/proc/meminfo <image-id> /bin/bash
3. Em seguida, são vistas no contêiner as informações de cpuinfo, stat, bem como meminfo, que pertencem apenas ao ponto de vista do contêiner.
Isolamento de pagecache
Quando o uso das páginas do arquivo de processo é excessivo, isso consome uma grande quantidade de memória, reduzindo a memória disponível para outros negócios. Esta alocação de memória ineficiente frequente de uma máquina pode facilmente desencadear erros de falta de memória(OOM). No cenário nativo da nuvem, expandimos o page cache do kernel, realizando o uso de page cache limit de contêineres, restringindo assim o uso de page cache de um contêiner individual.
Restrição de pagecache da máquina global:
sysctl -w vm.memory_qos=1sysctl -w vm.pagecache_limit_global=1
echo x > /proc/sys/vm/pagecache_limit_ratio#(0 < x < 100)Ative o page cache limit. Quando não for 0, por exemplo for 30, significa que page cache está limitado a 30% da memória total do sistema.
O processo de recuperação de dirty page é relativamente demorado. 'pagecache_limit_ignore_dirty ' é usado para determinar se dirty page é ignorada ao calcular a memória ocupada por 'pagecache '. Sua localização é a seguinte:
/proc/sys/vm/pagecache_limit_ignore_dirty。O valor padrão é 1, significa que dirty page é ignorada.
Defina o método da recuperação do page cache:
/proc/sys/vm/pagecache_limit_async
1 significa que recuperação assíncrona do page cache. O TencentOS criará um thread do kernel [kpclimitd] que será responsável pela recuperação do page cache.
0 significa que recuperação sincronizada. Nenhum thread de recuperação dedicado será criado. Recupere diretamente o contexto de processo acionada no page cache limit. O valor padrão é 0.
Restrição de pagecache de contêiner:
Além de suportar restrições de pagecache no nível global do sistema, o TencentOS também suporta restrições de pagecache no nível do contêiner. O uso é o seguinte:
1. Ative memória QOS:
sysctl -w vm.memory_qos=1
2. Desative o limite global de pagecache:
sysctl -w vm.pagecache_limit_global=0
3. Entre ao memcg do contêiner e defina o limite de memory:
echo value > memory.limit_in_bytes
4. Defina a quantidade máxima de pagecache como uma porcentagem do limite de memória atual. Por exemplo, definida como 10%:
echo 10 > memory.pagecache.max_ratio
5. Defina a proporção de recuperação quando excesso de limite de pagecache:
echo 5 > memory.pagecache.reclaim_ratio
Limite de velocidade unificado de leitura/gravação
A solução original de limite de velocidade IO do kernel Linux funciona de forma separada de leitura/gravação, que exige que o administrador divida a largura de banda IO de acordo com o modelo de negócios e implementem-nos separadamente. Isso resultando em desperdício de largura de banda. Por exemplo, se configurado for 50MB/s para leitura e 50MB/s para gravação, mas a largura de banda de IO real for 20MB/s para leitura e 50MB/s para gravação, assim 30MB/s de largura de banda de leitura será desperdiçada. Para resolver este problema, o TencentOS introduziu uma solução unificada de limite de velocidade de leitura/gravação. No modo usuário, esta solução fornece aos clientes uma interface unificada de configuração para limitação de velocidade de leitura/gravação e no modo de kernel aloca dinamicamente a proporção de leitura/gravação de acordo com o tráfego comercial. O método de uso é o seguinte:
Entre para o cgroup do negócio blkio correspondente e use a seguinte configuração: echo MAJ:MIN VAL > FILE.
No qual, MAJ:MIN representa o número do dispositivo, FILE e VAL são como mostrado na tabela abaixo:
FILE | VAL |
blkio.throttle.readwrite_bps_device | Ler e gravar valor de limite total Bps |
blkio.throttle.readwrite_iops_device | Ler e gravar limite total iops |
blkio.throttle.readwrite_dynamic_ratio | Proporção de leitura/gravação com previsão dinâmica: 0: Desativado. Use uma proporção fixa (leitura: gravação é 3:1) 1 a 5: Ative a solução de previsão dinâmica. |
Suporte ao limite de velocidade do buffer IO
No kernel nativo do Linux, o cgroup v1 tem certos defeitos na limitação da velocidade de buffer IO. O write back de buffer IO é geralmente um processo assíncrono, e o kernel não consegue determinar a qual blkio cgroup que o IO deve ser submetido ao executar operações assíncronas de limpeza suja, portanto, incapaz de aplicar a política de limite de velocidade blkio correspondente.
Baseando-se nisso, o TencentOS realizou uma melhoria completa na função de limitação de velocidade de buffer IO no cgroup v1, tornando-a consistente com a função de limitação de buffer IO baseada no cgroup v2. Para o cgroup v1, fornecemos uma interface de modo de usuário que permite a vincular o mem_cgroup pertencente ao page cache ao blkio cgroup correspondente, levando assim que o kernel limite a velocidade do buffer IO de acordo com as informações de vinculação.
1. Para ativar a função de limitação de velocidade do buffer IO, duas características precisam ser ativadas: kernel.io_qos e kernel.io_cgv1_buff_wb.
sysctl -w kernel.io_qos=1 # Ative a característica IO QoS
sysctl -w kernel.io_cgv1_buff_wb=1 # Ative a característica buffer IO (ativado por padrão)
2. Para implementar a limitação de velocidade de buffer IO para contêiner, é necessário vincular explicitamente o memcg correspondente ao contêineres com o cgroup do blkcg, da seguinte forma:
echo /sys/fs/cgroup/blkio/A > /sys/fs/cgroup/memory/A/memory.bind_blkio
Após a vinculação, o mecanismo de restrição de recursos de buffer IO para contêineres fornecido pelo blkio cgroup, poderá ser visualizado através das seguintes interfaces:
blkio.throttle.read_bps_device
blkio.throttle.write_bps_device
blkio.throttle.write_iops_device
blkio.throttle.read_iops_device
blkio.throttle.readwrite_bps_device
blkio.throttle.readwrite_iops_device
Assíncrono fork
Quando aplicação de grande memória executa uma chamada de sistema fork para criar um processo filho, o processo de chamada fork levará um tempo relativamente longo, fazendo com que o negócio possa estar no modo do kernel por um longo tempo e incapaz de processar solicitações de negócios. Portanto, torna-se particularmente necessário otimizar o tempo de fork do kernel para esse cenário.
Sob Linux, durante o processamento padrão do fork pelo kernel requer que o processo pai copiar uma grande quantidade de metadados de processo para o processo filho, onde a cópia da tabela de página é a parte mais demorada, geralmente ocupando mais de 97% do tempo de chamadas do fork. O fork assíncrono é projetado de transferir o trabalho de copiar tabelas de página do processo pai para o filho, encurtando assim o tempo para o processo pai invocar a chamada do sistema fork e entrando no modo kernel, permitindo que o aplicativo retorne rápidamente ao modo de usuário para processar solicitações de negócios, resolvendo assim o problema de oscilação de desempenho causado pelo fork.
Esta função é controlado ativando e desativando via
cgroup, o uso básico é seguinte:echo 1> <diretório cgroup >/memory.async_fork # Ative o assíncrono fork para o diretório cgroup atual Echo 0 > <diretório cgroup >/memory.async_fork # Desative o assíncrono fork para o diretório cgroup atual
O valor padrão deste interface é de 0, ou seja, está desativada por padrão.
Ajuda e Suporte
Esta página foi útil?
Você também pode entrar em contato com a Equipe de vendas ou Enviar um tíquete em caso de ajuda.
comentários